Spreidingsmaten zijn statistische getallen die laten zien hoe sterk de waarden in een dataset uiteenlopen. Terwijl een centrummaat zoals het gemiddelde het midden van je data aangeeft, vertelt een spreidingsmaat hoe ver de antwoorden daar vandaan liggen. De vijf meest gebruikte spreidingsmaten zijn de spreidingsbreedte (het verschil tussen hoogste en laagste waarde), de interkwartielafstand (de spreiding van de middelste 50 procent), de variantie, de standaarddeviatie (de gemiddelde afstand tot het gemiddelde) en de variatiecoëfficiënt (de spreiding als percentage van het gemiddelde). Samen met een centrummaat vormen ze het minimale duo om een reeks cijfers eerlijk samen te vatten.
Een gemiddelde alleen zegt verrassend weinig. Twee productlijnen kunnen allebei een gemiddelde tevredenheidsscore van 7 halen, terwijl de ene een tevreden en eensgezinde klantengroep heeft en de andere een kamp van fans tegenover een kamp van ontevredenen. Dat verschil zit niet in het gemiddelde, maar in de spreiding. Wie in marktonderzoek conclusies trekt zonder naar de spreiding te kijken, loopt het risico een scheef beeld te schetsen. In deze gids lees je wat spreidingsmaten zijn, hoe je ze berekent, en welke maat bij welke situatie past.
Wat zijn spreidingsmaten?
Een spreidingsmaat, ook wel spreidingsparameter genoemd, is een kerngetal dat de variatie binnen een verzameling waarnemingen samenvat. Het beschrijft in een enkel cijfer hoe dicht of hoe ver de datapunten bij elkaar liggen. Een lage spreiding betekent dat de meeste respondenten ongeveer hetzelfde antwoorden; een hoge spreiding betekent dat de meningen sterk verschillen.
Spreidingsmaten horen altijd samen met een centrummaat. De centrummaat (gemiddelde, mediaan of modus) vertelt waar het zwaartepunt van je data ligt, de spreidingsmaat vertelt hoe betrouwbaar dat zwaartepunt de hele groep vertegenwoordigt. Pas als je beide kent, weet je of een gemiddelde een representatief verhaal vertelt of een misleidende samenvatting is. Deze twee families samen vormen de basis van de beschrijvende statistiek, de eerste stap voordat je verder gaat met toetsende statistiek en zwaardere analysetechnieken.
In het Nederlandstalige statistiekonderwijs worden vaak drie klassieke spreidingsmaten onderscheiden: de spreidingsbreedte, de interkwartielafstand en de standaarddeviatie. Daarnaast rekenen onderzoekers met de variantie (de voorloper van de standaarddeviatie) en de variatiecoëfficiënt (voor vergelijkingen tussen verschillende schalen). We lopen die vijf een voor een langs.
Belangrijk is het verschil met een centrummaat nog even scherp te stellen. Een centrummaat comprimeert een hele reeks tot een enkel representatief getal en gooit daarmee bewust informatie weg. Een spreidingsmaat geeft een deel van die weggegooide informatie terug: ze kwantificeert hoeveel de individuele waarnemingen van dat ene getal afwijken. Twee datasets kunnen exact dezelfde mediaan en modus hebben en toch compleet verschillend ogen. Zonder spreidingsmaat zie je dat verschil niet, en trek je mogelijk conclusies die alleen voor een deel van je respondenten gelden.
De belangrijkste spreidingsmaten op een rij
De vijf spreidingsmaten verschillen in wat ze meten, hoe gevoelig ze zijn voor uitschieters en wanneer je ze inzet. De onderstaande tabel geeft het overzicht, daarna lichten we elke maat toe.
| Spreidingsmaat | Wat meet ze? | Gevoelig voor uitschieters? | Wanneer gebruiken |
|---|---|---|---|
| Spreidingsbreedte (range) | Verschil tussen hoogste en laagste waarde | Zeer gevoelig | Snelle eerste indruk van de breedte |
| Interkwartielafstand (IQR) | Spreiding van de middelste 50 procent | Robuust | Scheve data of uitschieters |
| Variantie | Gemiddelde gekwadrateerde afwijking | Gevoelig | Tussenstap en invoer voor toetsen |
| Standaarddeviatie | Gemiddelde afstand tot het gemiddelde | Gevoelig | Symmetrische data, rapportage |
| Variatiecoëfficiënt | Standaarddeviatie gedeeld door gemiddelde | Gevoelig | Schalen of eenheden vergelijken |
Spreidingsbreedte
De spreidingsbreedte, ook wel range of variatiebreedte, is de eenvoudigste spreidingsmaat: het verschil tussen de hoogste en de laagste waarde. Scoort je laagste respondent een 5 en je hoogste een 9, dan is de spreidingsbreedte 4. Het voordeel is de eenvoud, het nadeel is dat de maat volledig leunt op twee extreme punten. Een enkele uitschieter blaast de spreidingsbreedte meteen op, terwijl je over alle respondenten daartussen niets te weten komt.
Interkwartielafstand
De interkwartielafstand (IQR, van interquartile range) lost dat probleem op door alleen naar de middelste helft van de data te kijken. Je sorteert de waarden, bepaalt het eerste kwartiel (Q1, de waarde waaronder 25 procent valt) en het derde kwartiel (Q3, de waarde waaronder 75 procent valt). De interkwartielafstand is dan Q3 min Q1. Omdat de extremen buiten beschouwing blijven, is de IQR robuust tegen uitschieters en de logische partner van de mediaan. Deze maat vormt ook de basis van de boxplot, een veelgebruikte grafiek in datavisualisatie.
Variantie
De variantie kijkt niet naar twee punten, maar naar alle waarnemingen tegelijk. Je berekent voor elke waarde hoe ver ze van het gemiddelde ligt, kwadrateert die afwijkingen zodat negatieve en positieve verschillen elkaar niet opheffen, en middelt die kwadraten uit. Werk je met een steekproef in plaats van met een volledige populatie, dan deel je daarbij door het aantal waarnemingen min 1. Het resultaat staat in gekwadrateerde eenheden, wat de variantie lastig te interpreteren maakt: een variantie van 1,5 punt in het kwadraat zegt een mens weinig. Toch is de variantie onmisbaar, omdat ze de bouwsteen is van veel technieken, waaronder de variantieanalyse en Cronbach’s alpha.
Standaarddeviatie
De standaarddeviatie, ook wel de standaardafwijking genoemd, is de wortel uit de variantie. Door die worteltrekking komt de maat weer in de oorspronkelijke eenheid te staan, waardoor ze veel beter leesbaar is. Een standaarddeviatie van 1,2 op een schaal van 1 tot 10 betekent dat respondenten gemiddeld 1,2 punt van het gemiddelde afwijken. Ze is verreweg de meest gerapporteerde spreidingsmaat en vormt de brug naar de foutmarge rond een gemiddelde.
Verwar de standaarddeviatie niet met de standaardfout. De standaarddeviatie beschrijft hoe sterk je respondenten onderling verschillen en blijft ongeveer gelijk als je meer mensen bevraagt. De standaardfout beschrijft hoe precies je schatting van het gemiddelde is en wordt kleiner naarmate je steekproef groeit. Het zijn twee verschillende vragen, en ze door elkaar halen levert ofwel schijnzekerheid op, ofwel een onnodig alarmerend breed beeld.
Bij een bij benadering normaal verdeelde dataset krijgt de standaarddeviatie een extra betekenis. Dan ligt ongeveer 68 procent van de waarnemingen binnen een afstand van een standaarddeviatie rond het gemiddelde, en zo’n 95 procent binnen twee standaarddeviaties. Die vuistregel, bekend als de empirische regel, maakt van de standaarddeviatie meteen een hulpmiddel om in te schatten wat een normale waarde is en wat een uitzondering. Bij scheve verdelingen gaat die regel niet op, en dat is precies het moment om naar de interkwartielafstand over te stappen.
Variatiecoëfficiënt
De variatiecoëfficiënt deelt de standaarddeviatie door het gemiddelde en wordt meestal als percentage weergegeven. Daardoor wordt spreiding vergelijkbaar tussen reeksen met heel verschillende schalen of eenheden. Wil je weten of de prijsspreiding van koffie relatief groter is dan die van thee, dan vergelijk je niet de ruwe standaarddeviaties, maar de variatiecoëfficiënten. De maat werkt alleen zinvol bij data met een echt nulpunt en een positief gemiddelde.
Spreidingsmaten berekenen: een rekenvoorbeeld
Stel dat je negen klanten hun tevredenheid laat scoren op een schaal van 1 tot 10. De antwoorden zijn: 5, 6, 6, 7, 7, 7, 8, 8 en 9. Het gemiddelde is 63 gedeeld door 9, dus precies 7,0, en de mediaan is eveneens 7. Dat zijn de centrummaten. Nu de spreiding.
| Spreidingsmaat | Berekening | Resultaat |
|---|---|---|
| Spreidingsbreedte | 9 min 5 | 4 |
| Eerste kwartiel (Q1) | Mediaan van 5, 6, 6, 7 | 6 |
| Derde kwartiel (Q3) | Mediaan van 7, 8, 8, 9 | 8 |
| Interkwartielafstand | 8 min 6 | 2 |
| Variantie (steekproef) | Som gekwadrateerde afwijkingen (12) gedeeld door 8 | 1,5 |
| Standaarddeviatie | Wortel uit 1,5 | 1,22 |
| Variatiecoëfficiënt | 1,22 gedeeld door 7,0 | 17 procent |
De gekwadrateerde afwijkingen tel je op als volgt: de waarden 5 en 9 liggen 2 punten van het gemiddelde (elk 4 in het kwadraat), de drie zevens liggen er 0 vandaan, en de overige vier waarden liggen er 1 vandaan (elk 1 in het kwadraat). Dat levert 4 plus 1 plus 1 plus 0 plus 0 plus 0 plus 1 plus 1 plus 4, samen 12. In marktonderzoek deel je door het aantal respondenten min 1 (hier 8), omdat je met een steekproef werkt en niet met de volledige populatie. De standaarddeviatie van 1,22 vertelt je dat de typische klant iets meer dan een punt van het groepsgemiddelde afwijkt: een redelijk eensgezinde groep.
Waarom je centrummaat en spreidingsmaat samen leest
Het belang van spreidingsmaten wordt pas echt zichtbaar als je twee groepen met hetzelfde gemiddelde vergelijkt. Stel, twee producten halen allebei een gemiddelde tevredenheid van 7,0, maar de spreiding verschilt sterk.
| Scores (1 tot 10) | Gemiddelde | Standaarddeviatie | Interpretatie |
|---|---|---|---|
| Product A: 6, 7, 7, 7, 7, 7, 7, 7, 8 | 7,0 | 0,5 | Eensgezind tevreden, voorspelbaar |
| Product B: 4, 4, 5, 7, 7, 7, 9, 10, 10 | 7,0 | 2,35 | Fans en haters, gepolariseerd |
Op papier presteren beide producten identiek. In werkelijkheid vragen ze om een totaal andere strategie. Product A heeft een stabiele, tevreden klantenbasis. Product B polariseert: een deel is enthousiast, een deel haakt af. Een beslissing die alleen op het gemiddelde steunt, zou die polarisatie volledig missen. Dit is precies waarom een klanttevredenheidsonderzoek nooit stopt bij een gemiddelde score, maar altijd de spreiding erbij rapporteert. Hetzelfde geldt bij consumentenonderzoek en B2B-marktonderzoek, waar een gemiddelde zonder spreiding de besluitvorming op het verkeerde been kan zetten.
De spreiding bepaalt ook hoe je een verschil tussen twee groepen beoordeelt. Liggen twee gemiddelden een halve punt uit elkaar, dan is dat veel bij een eensgezinde groep en weinig bij een verdeelde. Daarom drukt de effectgrootte een verschil niet uit in ruwe punten, maar in standaarddeviaties.
Welke spreidingsmaat kies je?
De juiste spreidingsmaat hangt af van het meetniveau van je variabele en van de vorm van de verdeling. Een spreidingsmaat op een verkeerd meetniveau toepassen levert een getal op dat er geleerd uitziet maar niets betekent. De onderstaande tabel geeft richting.
| Situatie | Beste spreidingsmaat | Bijpassende centrummaat |
|---|---|---|
| Symmetrische, klokvormige data | Standaarddeviatie | Gemiddelde |
| Scheve data of uitschieters | Interkwartielafstand | Mediaan |
| Ordinale data (rangorde) | Interkwartielafstand | Mediaan |
| Nominale data (categorieën) | Geen klassieke spreidingsmaat | Modus |
| Vergelijken tussen schalen | Variatiecoëfficiënt | Gemiddelde |
De vuistregel is eenvoudig. Is je data bij benadering symmetrisch verdeeld, dan passen gemiddelde en standaarddeviatie samen. Zijn er uitschieters of is de verdeling scheef, dan zijn mediaan en interkwartielafstand het betrouwbaardere koppel. Werk je met rangordes, zoals de antwoorden op een Likert-schaal, of met categorieën, dan is een standaarddeviatie simpelweg niet gedefinieerd en val je terug op de interkwartielafstand of op frequenties. Een goede analyse begint dus niet bij de rekenmachine, maar bij het bepalen van het meetniveau en het bekijken van de verdeling.
Spreidingsmaten in marktonderzoek
In de praktijk gebruik je spreidingsmaten in bijna elk kwantitatief onderzoek. Bij een tevredenheidsmeting laat de standaarddeviatie zien of een goede gemiddelde score door iedereen gedragen wordt of door een verdeeld publiek. Bij prijsonderzoek toont de spreiding hoe sterk de betalingsbereidheid uiteenloopt, wat direct raakt aan je prijsstrategie. Bij een representatieve steekproef helpt de spreiding om te beoordelen hoeveel vertrouwen je in het gemiddelde mag hebben: hoe groter de spreiding, hoe meer respondenten je nodig hebt voor eenzelfde nauwkeurigheid. Dat verband werkt ook door in de berekening van je steekproefgrootte.
Ook buiten tevredenheid en prijs speelt spreiding een hoofdrol. In een medewerkersbevraging verraadt een grote spreiding op een stelling vaak een onderliggend conflict tussen afdelingen dat in het gemiddelde volledig wegvalt. Bij marktsegmentatie is spreiding zelfs het startpunt: je zoekt juist naar groepen die onderling verschillen, dus een hoge spreiding in de totale steekproef is een signaal dat een clusteranalyse zinvolle segmenten zal opleveren. En let op: spreiding is iets anders dan samenhang. Dat twee variabelen allebei sterk spreiden, zegt op zich niets over of ze met elkaar verband houden. Daarvoor heb je andere technieken nodig, zoals je leest in onze gids over correlatie en causaliteit. Of spreiding kwalitatief of kwantitatief in beeld komt, hangt bovendien af van je aanpak, zoals beschreven in het verschil tussen kwalitatief en kwantitatief onderzoek.
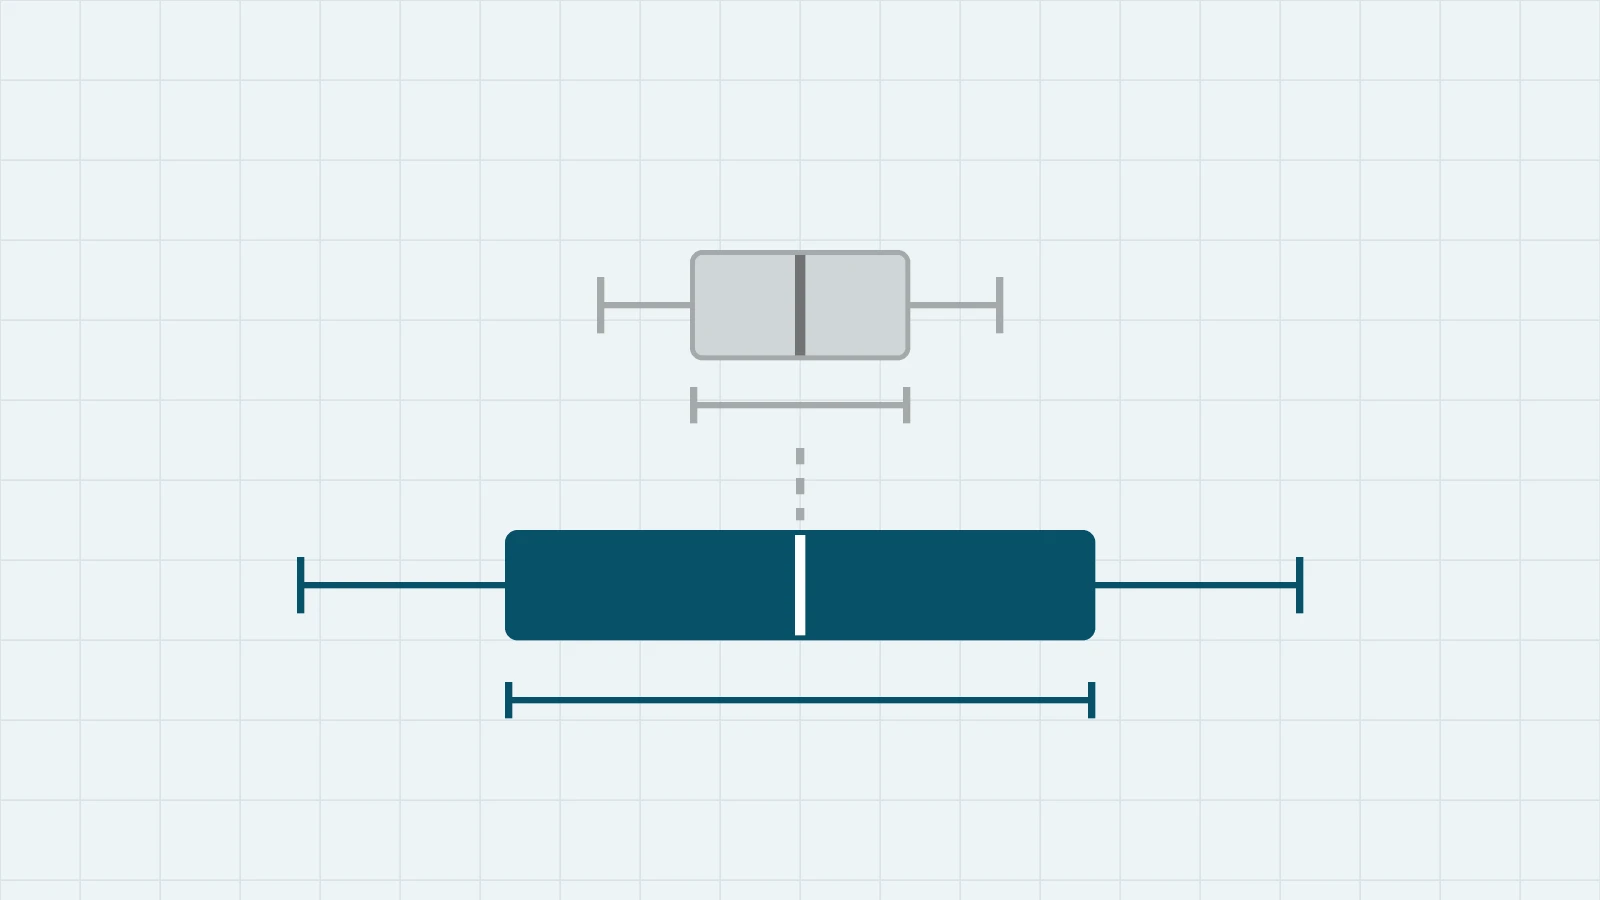
Visueel wordt spreiding vaak weergegeven met een boxplot. Die grafiek tekent een doos van Q1 tot Q3, met de mediaan als streep in het midden en snorharen naar de uiterste waarden. In een oogopslag zie je de interkwartielafstand, de scheefheid en de uitschieters. De boxplot gaat terug op het werk van statisticus John Tukey in de jaren zeventig, terwijl de term standaarddeviatie in 1894 van Karl Pearson komt en de variantie in 1918 van Ronald Fisher. Een goed onderzoeksbureau combineert deze visuele en numerieke blik, en zet spreiding in het onderzoeksrapport niet weg als bijzaak maar als vast onderdeel van elke conclusie. Benieuwd hoe zo’n analyse in een volledig traject past? Lees dan hoe een marktonderzoek bij BABLR verloopt.
Vijf veelgemaakte fouten met spreidingsmaten
Software als Excel, SPSS en zelfs AI-assistenten rekenen een standaarddeviatie of variantie in een seconde uit, op elke dataset die je erin gooit. Dat is handig, maar het is ook de kern van het probleem: de drempel om een spreidingsmaat verkeerd te gebruiken is gedaald tot nul. De rekenmachine controleert niet of de maat bij je data past. Juist daarom is de inhoudelijke blik van een onderzoeker belangrijker geworden, niet minder belangrijk. Dit zijn de valkuilen die wij in de praktijk het vaakst zien.
Elk van deze fouten is met het blote oog onzichtbaar in de uitkomst, en precies daarom zo gevaarlijk. Een verkeerd gekozen spreidingsmaat levert geen foutmelding op, alleen een getal dat de verkeerde kant op wijst.
Van spreiding naar onderbouwde beslissing
Spreidingsmaten zijn geen academische franje, maar het verschil tussen een cijfer dat je begrijpt en een cijfer dat je misleidt. Ze vertellen of een gemiddelde de hele groep vertegenwoordigt of slechts een gemiddeld compromis tussen uitersten. Wie zijn data serieus neemt, leest centrummaat en spreidingsmaat altijd samen, kiest de maat die bij het meetniveau en de verdeling past, en vertaalt de spreiding naar wat ze voor de business betekent. Wil je zeker weten dat jouw cijfers kloppen en de juiste conclusies dragen? Bekijk dan de mogelijkheden van marktonderzoek door BABLR, en laat de analyse over aan mensen die weten welke maat wanneer telt.
Veelgestelde vragen over spreidingsmaten
Spreidingsmaten zijn getallen die laten zien hoe sterk de waarden in een dataset uiteenlopen rond het gemiddelde of de mediaan. Waar een centrummaat het midden aangeeft, laat een spreidingsmaat zien hoe verspreid de antwoorden liggen. De bekendste zijn de spreidingsbreedte, de interkwartielafstand, de variantie en de standaarddeviatie.
In de praktijk komen er drie steeds terug: de spreidingsbreedte (het verschil tussen de hoogste en de laagste waarde), de interkwartielafstand (de spreiding van de middelste 50 procent) en de standaarddeviatie (de gemiddelde afstand tot het gemiddelde). De variantie is het kwadraat van de standaarddeviatie, en de variatiecoëfficiënt maakt spreiding vergelijkbaar tussen schalen.
De variantie is het gemiddelde van de gekwadrateerde afwijkingen tot het gemiddelde en staat dus in kwadraateenheden. De standaarddeviatie is de wortel uit de variantie en staat weer in dezelfde eenheid als je data. Daardoor is de standaarddeviatie makkelijker te interpreteren: zij vertelt letterlijk hoeveel punten respondenten gemiddeld van het gemiddelde afwijken.
Een grote standaarddeviatie betekent dat de antwoorden sterk uiteenlopen: er zit veel variatie in je steekproef. Een kleine standaarddeviatie betekent dat de meeste waarden dicht bij het gemiddelde liggen en de groep het dus redelijk eens is. Twee groepen met hetzelfde gemiddelde kunnen een heel verschillende standaarddeviatie hebben.
Bij scheve verdelingen of uitschieters is de interkwartielafstand de veiligste keuze, want die kijkt alleen naar de middelste 50 procent en wordt niet meegetrokken door extreme waarden. De standaarddeviatie en de spreidingsbreedte zijn juist erg gevoelig voor uitschieters. Combineer de interkwartielafstand dan met de mediaan als centrummaat.
Spreidingsmaten worden pas stabiel bij voldoende waarnemingen. Bij een handvol respondenten verschuift de standaarddeviatie al sterk door een enkele uitschieter. Een steekproef van enkele honderden respondenten geeft doorgaans een betrouwbaar beeld, maar het exacte aantal hangt af van je populatie en de gewenste nauwkeurigheid. Een onderzoeksbureau rekent de benodigde steekproefgrootte vooraf door.