Variantieanalyse, internationaal bekend als ANOVA (analysis of variance), is een statistische toets die nagaat of het gemiddelde van drie of meer groepen echt van elkaar verschilt. Waar een t-toets precies twee gemiddelden vergelijkt, doet variantieanalyse dat voor drie of meer groepen in een enkele toets, zonder dat de kans op een toevalstreffer oploopt. De methode splitst de totale spreiding in je data op in variatie tussen de groepen en variatie binnen de groepen, en toetst met de F-waarde of het verschil tussen de groepen groter is dan wat je op grond van toeval mag verwachten.
Voor een marktonderzoeker is dat een van de meest bruikbare toetsen die er bestaan. De vraag of drie vestigingen even tevreden klanten hebben, of vier prijspunten evenveel kooplust opwekken, of vijf campagnevarianten dezelfde merkwaardering opleveren, is telkens dezelfde vraag: verschillen deze groepen echt, of is wat we zien gewoon ruis? Dit artikel legt uit hoe een variantieanalyse werkt, welke vormen er zijn, welke voorwaarden ze stelt en waar het in de praktijk misgaat.
Variantieanalyse in het kort: een toets voor meerdere groepen tegelijk
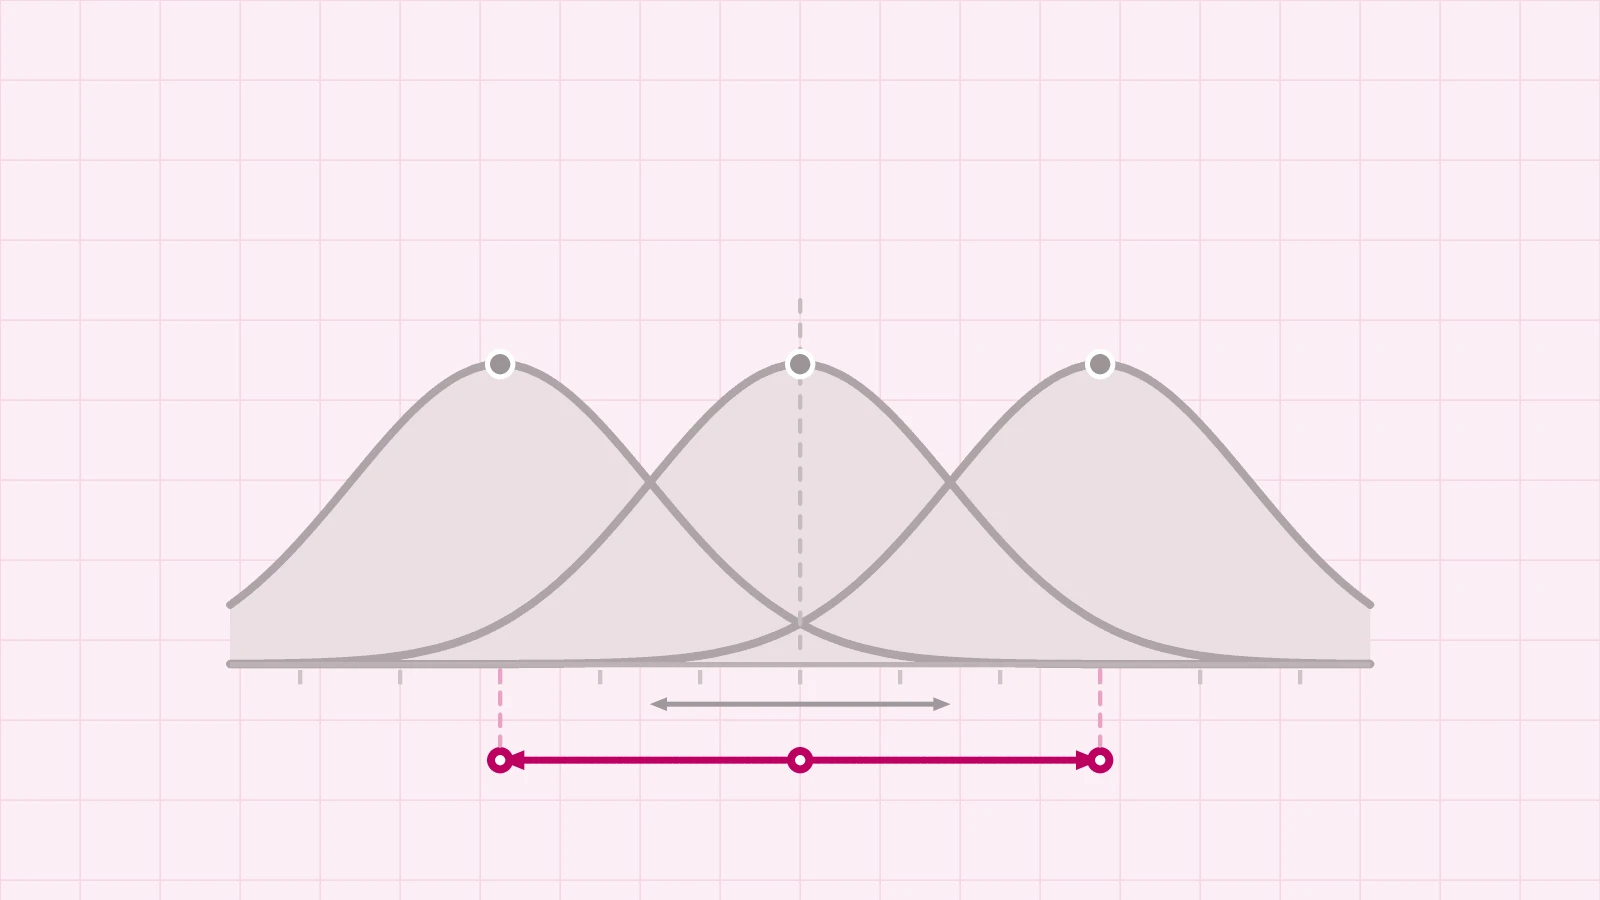
Variantieanalyse is bedacht door de Britse statisticus Ronald Fisher in de jaren twintig van de vorige eeuw. De naam klinkt tegenintuïtief: je wil verschillen tussen gemiddelden aantonen, maar de techniek heet naar de variantie, de spreiding. Dat is precies de kern van het idee. Fisher besefte dat je verschillen tussen groepsgemiddelden het best beoordeelt door twee soorten spreiding tegen elkaar af te wegen.
De eerste is de spreiding tussen de groepen: hoe ver liggen de groepsgemiddelden uit elkaar? De tweede is de spreiding binnen de groepen: hoeveel verschillen individuele respondenten binnen eenzelfde groep van elkaar? Als de gemiddelden ver uit elkaar liggen ten opzichte van de ruis binnen de groepen, is er waarschijnlijk een echt verschil. Liggen ze dicht bij elkaar in vergelijking met die interne ruis, dan is er geen reden om van een verschil te spreken. Variantieanalyse giet die afweging in een getal, de F-waarde, en koppelt daar een significantieniveau aan. Het is daarmee een van de meest gebruikte statistische technieken in marktonderzoek.
Meerdere t-toetsen stapelen vergroot de kans op een toevalstreffer
Een logische vraag is: waarom niet gewoon een reeks t-toetsen draaien? Als je drie groepen hebt, kan je toch A met B, A met C en B met C vergelijken? Technisch kan dat, maar statistisch is het een valkuil. Elke afzonderlijke toets die je op een grens van 0,05 uitvoert, heeft vijf procent kans om een verschil te zien dat er niet is. Zodra je meerdere toetsen naast elkaar legt, stapelt die kans zich op.
Bij drie groepen doe je al drie paarsgewijze vergelijkingen, en dan loopt de kans op minstens een vals-positief resultaat op van vijf procent naar ongeveer veertien procent. Bij vijf groepen zijn er tien vergelijkingen en is die kans meer dan veertig procent. Je zou dan een verschil rapporteren dat puur op toeval berust. Dit heet kanskapitalisatie. Variantieanalyse lost het op door alle groepen in een enkele overkoepelende toets te vergelijken, waarbij het significantieniveau intact blijft. Meer over de betekenis van die grens lees je in ons artikel over statistische significantie.
ANOVA splitst de variatie tussen en binnen de groepen op
De motor onder de variantieanalyse is een deling. De totale variatie in je data wordt opgesplitst in twee delen. Het eerste deel is de variatie tussen de groepen, de mate waarin de groepsgemiddelden afwijken van het totale gemiddelde. Het tweede deel is de variatie binnen de groepen, de mate waarin individuele scores afwijken van het gemiddelde van hun eigen groep. Dat laatste is in feite de natuurlijke ruis: geen twee klanten geven exact hetzelfde cijfer.
De F-waarde is de verhouding tussen die twee: de gemiddelde variatie tussen de groepen gedeeld door de gemiddelde variatie binnen de groepen. Een F-waarde rond 1 betekent dat de verschillen tussen de groepen niet groter zijn dan de gewone ruis, en dus geen aanwijzing voor een echt verschil. Een duidelijk hogere F-waarde betekent dat de groepen verder uit elkaar liggen dan je op grond van toeval zou verwachten. De p-waarde vertaalt de F-waarde ten slotte naar een kans, zodat je kan beslissen of het verschil significant is. Belangrijk: een significant verschil in gemiddelde is nog geen bewijs van oorzaak en gevolg, net zoals bij correlatie en causaliteit.
One-way en two-way variantieanalyse dekken de meeste onderzoeksvragen
Variantieanalyse komt in verschillende vormen, afhankelijk van hoeveel indelingsvariabelen je gebruikt en hoe je data is opgebouwd. Voor het overgrote deel van het marktonderzoek volstaan de eerste twee vormen hieronder; de laatste twee kom je tegen zodra je dezelfde mensen meerdere keren meet of meerdere uitkomsten tegelijk wil toetsen.
Het verschil tussen one-way en two-way is meer dan een technisch detail. Met een two-way variantieanalyse kan je een interactie-effect opsporen. Stel dat vestiging A het beter doet bij particulieren en vestiging B beter bij zakelijke klanten. Een one-way analyse per vestiging zou dat verschil middelen en verbergen. De two-way variant maakt zichtbaar dat het effect van de vestiging afhangt van het klanttype. Dat soort inzicht is vaak waardevoller dan het hoofdeffect zelf.
Een betrouwbare ANOVA staat of valt met vier voorwaarden
Variantieanalyse is krachtig, maar niet vrijblijvend. De uitkomst is alleen te vertrouwen als aan een aantal voorwaarden is voldaan. Wie die overslaat, krijgt een keurige F-waarde die niets betekent. Bij elke voorwaarde staat hieronder hoe je ze controleert.
Wordt aan een voorwaarde niet voldaan, dan is er bijna altijd een alternatief. Zijn de varianties duidelijk ongelijk, dan gebruik je een Welch-ANOVA, die daar robuust mee omgaat. Zijn de scores sterk scheef verdeeld of eigenlijk ordinaal, bijvoorbeeld een ruwe Likert-schaal, dan is de Kruskal-Wallis-toets een niet-parametrisch alternatief dat met rangordes werkt in plaats van met gemiddelden. De kunst is niet om de toets koste wat het kost door te drukken, maar om de juiste variant bij je data te kiezen. Dat begint bij een goede opzet, waaronder voldoende respondenten per groep. Hoeveel dat er zijn, bepaal je bij voorkeur vooraf, zoals we uitleggen in ons artikel over de steekproefgrootte bepalen.
Een significante uitslag vraagt om een post-hoctoets
Hier gaat het in de praktijk vaak mis. Een significante variantieanalyse vertelt je maar een ding: ergens tussen de groepen zit een echt verschil. Ze zegt niet tussen welke groepen. Met drie vestigingen weet je na een significante ANOVA nog niet of A van B verschilt, B van C, of alle drie onderling. De F-toets is een omnibustoets, een algemene alarmbel.
Om te achterhalen welke groepen precies verschillen, gebruik je een post-hoctoets. De bekendste is de Tukey HSD, die alle paren onderling vergelijkt en daarbij corrigeert voor het aantal vergelijkingen. Een alternatief is de Bonferroni-correctie, die de grens per vergelijking strenger maakt. Zonder deze stap val je terug op precies de kanskapitalisatie die de ANOVA juist wilde voorkomen. De volgorde is dus altijd: eerst de overkoepelende toets, en pas bij een significant resultaat de gerichte paarsgewijze vergelijkingen.
De F-waarde zegt of er verschil is, de effectgrootte zegt hoe groot
Statistische significantie en praktische relevantie zijn niet hetzelfde. Bij een grote steekproef wordt zelfs een minuscuul verschil tussen gemiddelden al snel significant, terwijl het voor je beslissing niets uitmaakt. Daarom hoort bij elke variantieanalyse ook een effectgrootte.
De gebruikelijke maat is eta-kwadraat, de proportie van de totale variatie in de uitkomst die door de groepsindeling wordt verklaard. Een eta-kwadraat van 0,06 betekent dat ongeveer zes procent van de spreiding in bijvoorbeeld tevredenheid samenhangt met de vestiging. Als vuistregel gelden waarden rond 0,01 als klein, rond 0,06 als middelgroot en vanaf 0,14 als groot. Een verwante en iets minder vertekende maat is omega-kwadraat. Rapporteer je alleen de p-waarde, dan mist je opdrachtgever de vraag die er echt toe doet: is dit verschil groot genoeg om er iets mee te doen?
Variantieanalyse in de praktijk: tevredenheid over drie vestigingen
Een voorbeeld maakt het concreet. Dit is een illustratief scenario. Een retailketen wil weten of de klanttevredenheid verschilt tussen drie vestigingen. Van elke vestiging worden de rapportcijfers van een steekproef klanten verzameld.
| Vestiging | Aantal respondenten | Gemiddeld cijfer |
|---|---|---|
| Vestiging A | 90 | 7,2 |
| Vestiging B | 95 | 7,8 |
| Vestiging C | 85 | 6,9 |
Een one-way variantieanalyse levert een F-waarde van 6,4 met een p-waarde van 0,002. Die ligt onder 0,05, dus er is een significant verschil tussen de vestigingen. Maar tussen welke? De Tukey-post-hoctoets laat zien dat vestiging B significant hoger scoort dan vestiging C, met een verschil van bijna een vol punt, terwijl het verschil tussen A en B en tussen A en C binnen de ruis blijft. De eta-kwadraat komt uit op ongeveer 0,046, een klein tot middelgroot effect: iets minder dan vijf procent van de verschillen in tevredenheid hangt samen met de vestiging.
De vertaalslag naar de opdrachtgever is dan niet dat alle drie de vestigingen verschillen, maar dat vestiging C achterblijft bij vestiging B en dat het de moeite loont om te achterhalen waarom. Zo wordt een toets een aanleiding voor gericht vervolgonderzoek in plaats van een losse tabel. Dezelfde aanpak werkt voor klanttevredenheidsonderzoek over kanalen, teams of periodes, en voor prijsanalyse waarbij je de kooplust bij verschillende prijspunten vergelijkt.
Welke toets past bij welke onderzoeksvraag
Variantieanalyse staat niet op zichzelf. Ze is een van de bouwstenen in een familie van toetsen, en de kunst is om per vraag de juiste te kiezen. De onderstaande tabel helpt je op weg.
| Onderzoeksvraag | Variabelen | Toets |
|---|---|---|
| Verschil tussen twee gemiddelden | Een numerieke uitkomst, twee groepen | T-toets |
| Verschil tussen drie of meer gemiddelden | Een numerieke uitkomst, drie of meer groepen | Variantieanalyse (ANOVA) |
| Samenhang tussen twee categorische variabelen | Twee categorische variabelen | Chi-kwadraattoets |
| Samenhang tussen twee numerieke variabelen | Twee numerieke variabelen | Correlatie |
| Een numerieke uitkomst voorspellen | Een uitkomst en meerdere voorspellers | Regressieanalyse |
De t-toets en de variantieanalyse zijn nauw verwant: een ANOVA met exact twee groepen geeft dezelfde conclusie als een t-toets. Variantieanalyse is dus in zekere zin de uitbreiding van de t-toets naar meer dan twee groepen. En wie dieper gaat, ontdekt dat ANOVA zelf een bijzonder geval is van regressieanalyse. Voor de meeste toepassingen hoef je dat verband niet te doorgronden, maar het verklaart waarom deze toetsen dezelfde taal spreken. Al deze technieken werken alleen op kwantitatieve data, zoals we toelichten in het artikel over het verschil tussen kwalitatief en kwantitatief marktonderzoek.
Vijf veelgemaakte fouten bij een variantieanalyse
Een variantieanalyse draaien is met moderne software een kwestie van enkele klikken. Juist daardoor sluipen er fouten in die de uitkomst waardeloos of zelfs misleidend maken. Dit zijn de vijf die we het vaakst zien.
Die laatste fout begint al ver voor de analyse. Een goede opzet vraagt genoeg respondenten per groep en een steekproef die de doelgroep weerspiegelt, iets wat je onder meer bewaakt met weging en raking.
Waarom een variantieanalyse geen doe-het-zelfklus is
De rekenkant van variantieanalyse is vandaag gratis en laagdrempelig. Elk statistiekpakket, elke spreadsheet met een uitbreiding en zelfs een AI-assistent produceert in enkele seconden een F-waarde en een p-waarde. Precies daar zit het risico. De drempel om de toets uit te voeren is gedaald, maar de drempel om ze verkeerd uit te voeren is even hard mee gezakt. Een mooi ogende ANOVA-tabel die stoelt op geschonden voorwaarden, ontbrekende post-hoctoetsen of een steekproef die te klein is, geeft geen kennis maar een vals gevoel van zekerheid. En een verkeerde conclusie waar met overtuiging naar wordt gehandeld, is schadelijker dan geen conclusie.
Het vakwerk zit niet in het indrukken van de knop. Het zit in de keuze van de juiste variant, het controleren en zo nodig corrigeren van de aannames, het correct interpreteren van de post-hocresultaten, het inschatten van de effectgrootte en het vertalen van dat alles naar een beslissing die hout snijdt. Dat is precies waar een ervaren onderzoeksbureau het verschil maakt: niet door een som te maken die iedereen kan maken, maar door ervoor te zorgen dat het antwoord ook echt klopt en dat je er de juiste gevolgtrekkingen aan verbindt. Meer over hoe zo’n traject verloopt, lees je in ons overzicht van marktonderzoek en in de uitleg over hoe een marktonderzoek via BABLR verloopt.
Laat je data het juiste verhaal vertellen
Variantieanalyse is een van de betrouwbaarste manieren om te bepalen of verschillen tussen meerdere groepen echt zijn of toeval. Toegepast met de juiste voorwaarden, de nodige post-hoctoetsen en een eerlijke blik op de effectgrootte, zet ze ruwe cijfers om in beslissingen waar je op kan bouwen. Wil je zeker weten dat de verschillen in je onderzoek statistisch kloppen en de juiste conclusies opleveren? Bekijk dan het volledige aanbod aan soorten marktonderzoek of neem contact op met BABLR voor een vrijblijvend gesprek.
Veelgestelde vragen over variantieanalyse (ANOVA)
Variantieanalyse, in het Engels ANOVA (analysis of variance), is een statistische toets die nagaat of het gemiddelde van drie of meer groepen significant van elkaar verschilt. De methode splitst de totale spreiding in de data op in variatie tussen de groepen en variatie binnen de groepen en toetst met de F-waarde of het verschil tussen de groepen groter is dan wat je door toeval zou verwachten.
Een t-toets vergelijkt precies twee gemiddelden. Zodra je drie of meer groepen tegelijk wil vergelijken, gebruik je variantieanalyse. ANOVA toetst alle groepen in een keer, waardoor de kans op een toevalstreffer niet oploopt zoals bij het stapelen van meerdere aparte t-toetsen. De afhankelijke variabele moet numeriek zijn, bijvoorbeeld een rapportcijfer of een bedrag.
Bij one-way variantieanalyse verklaar je verschillen in gemiddelde vanuit een enkele indelingsvariabele, bijvoorbeeld de vestiging. Bij two-way variantieanalyse kijk je naar twee indelingsvariabelen tegelijk, bijvoorbeeld vestiging en klanttype, en kan je bovendien nagaan of er een interactie is: werkt de ene factor anders uit afhankelijk van de andere.
Een klassieke ANOVA gaat uit van vier voorwaarden: onafhankelijke waarnemingen, een numerieke afhankelijke variabele, bij benadering normaal verdeelde scores binnen elke groep en ongeveer gelijke varianties tussen de groepen. Zijn de varianties niet gelijk, dan gebruik je een Welch-ANOVA. Zijn de scores sterk scheef of ordinaal, dan is de Kruskal-Wallis-toets een niet-parametrisch alternatief.
Een significante ANOVA vertelt je alleen dat er ergens een verschil zit, niet tussen welke groepen. Een post-hoctoets zoals Tukey HSD of een Bonferroni-correctie vergelijkt de groepen daarna paarsgewijs en houdt daarbij rekening met het aantal vergelijkingen, zodat de kans op vals-positieve resultaten onder controle blijft.
De F-waarde is de verhouding tussen de variatie tussen de groepen en de variatie binnen de groepen. Hoe hoger de F-waarde, hoe sterker de groepen verschillen ten opzichte van de ruis. De p-waarde vertaalt die F-waarde naar een kans: ligt ze onder je grens, meestal 0,05, dan noem je het verschil statistisch significant. De effectgrootte, zoals eta-kwadraat, zegt vervolgens hoe groot dat verschil in de praktijk is.