Effectgrootte is een gestandaardiseerde maat die aangeeft hoe groot een verschil of samenhang werkelijk is, los van de steekproefomvang. Waar statistische significantie enkel vertelt of een effect waarschijnlijk niet op toeval berust, vertelt de effectgrootte hoe sterk dat effect is en of het er in de praktijk toe doet. In marktonderzoek voorkomt ze de klassieke denkfout waarbij een statistisch significant maar triviaal verschil wordt gepresenteerd als een belangrijke bevinding.
Veel rapporten blijven steken bij de vraag of een verschil significant is. Dat is de verkeerde vraag om een beslissing op te bouwen. Een directie wil niet weten of variant B toevallig beter scoort dan variant A, ze wil weten hoeveel beter, en of dat de investering waard is. Precies daar komt effectgrootte in beeld. In dit artikel leggen we uit wat effectgrootte is, hoe ze zich verhoudt tot significantie, welke maten je wanneer gebruikt en hoe je ze correct interpreteert en rapporteert.
Wat is effectgrootte?
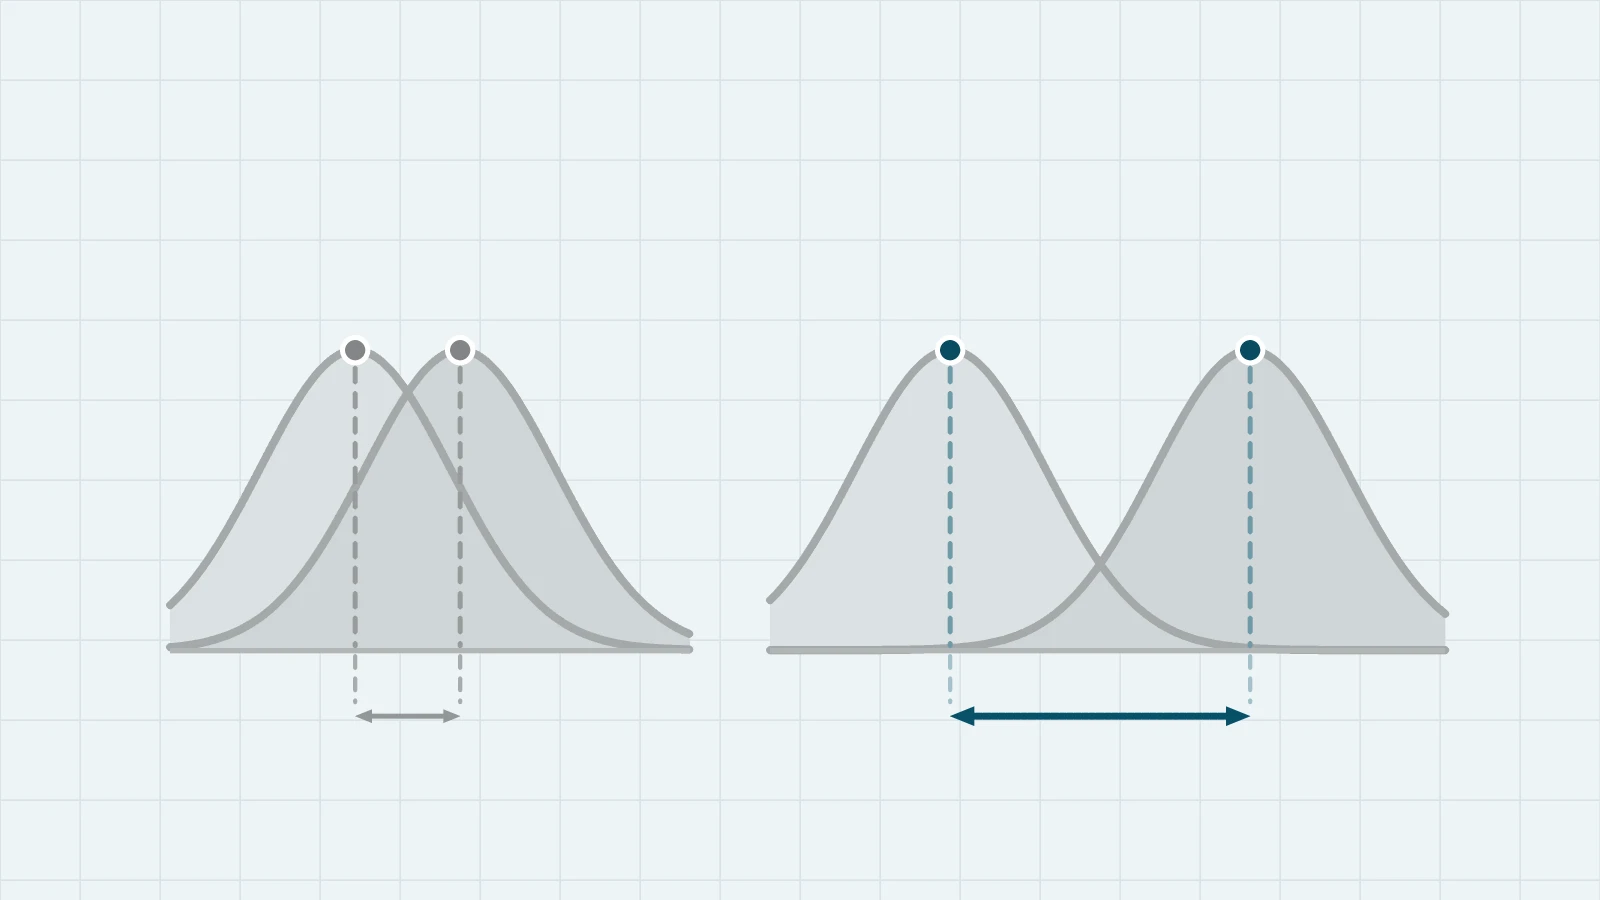
Effectgrootte is een getal dat de omvang van een fenomeen uitdrukt op een gestandaardiseerde, vergelijkbare manier. Bij een verschil tussen twee groepen zegt de effectgrootte hoe ver de gemiddelden uit elkaar liggen, uitgedrukt in standaarddeviaties in plaats van in ruwe eenheden. Bij een samenhang tussen twee variabelen zegt ze hoe sterk die samenhang is op een schaal van nul tot een.
De kern zit in het woord gestandaardiseerd. Stel dat de ene enquête tevredenheid meet op een schaal van 1 tot 10 en de andere op een schaal van 1 tot 100. Een ruw verschil van 3 punten betekent in beide gevallen iets totaal anders. Door het verschil te delen door de spreiding in de data maak je resultaten onderling vergelijkbaar, over studies, schalen en markten heen. Die vergelijkbaarheid maakt effectgrootte tot een van de meest onderschatte begrippen bij de meest gebruikte statistische technieken in marktonderzoek.
Effectgrootte hoort thuis in kwantitatief onderzoek, waar je met cijfers en steekproeven werkt. In kwalitatief onderzoek, waar je met interviews en observaties werkt, speelt het begrip geen rol. Daar gaat het om betekenis en patronen, niet om gestandaardiseerde getallen.
Effectgrootte versus statistische significantie: het cruciale verschil
Dit is het misverstand dat de meeste schade aanricht in marktonderzoekrapporten. Statistische significantie en effectgrootte beantwoorden twee verschillende vragen. Statistische significantie beantwoordt de vraag: is dit effect waarschijnlijk echt, of kan het toeval zijn? Effectgrootte beantwoordt de vraag: hoe groot is het effect?
Een p-waarde onder 0,05 betekent dat een gevonden verschil onwaarschijnlijk is als er in werkelijkheid geen verschil zou zijn. Het zegt niets over de omvang. Twee resultaten met exact dezelfde p-waarde kunnen een compleet andere praktische betekenis hebben. Omgekeerd kan een groot, relevant effect net niet significant zijn omdat de steekproef te klein was. Significantie en omvang zijn dus niet inwisselbaar, ze vullen elkaar aan. Een compleet resultaat rapporteert altijd beide: de p-waarde voor de betrouwbaarheid en de effectgrootte voor de relevantie.
Een handige samenvatting: de p-waarde is de bewaker aan de poort die zegt of je het effect serieus mag nemen, en de effectgrootte is de meetlat die zegt hoeveel het effect waard is. Wie enkel op de eerste let, laat de belangrijkste helft van het verhaal liggen.
De belangrijkste effectmaten op een rij
Er bestaat niet een enkele effectgrootte. De maat die je kiest, hangt af van het type analyse en het meetniveau van je variabelen. Dit zijn de vijf die je in marktonderzoek het vaakst tegenkomt.
Cohens d is verreweg de bekendste en komt van start zodra je met een t-toets twee groepen vergelijkt. De correlatiecoëfficiënt r is tegelijk toets en effectmaat: het getal zelf drukt de sterkte van het verband al uit. Bij regressieanalyse lees je de effectgrootte af aan R-kwadraat, en bij een chi-kwadraattoets vult Cramérs V, genoemd naar de Zweedse wiskundige Harald Cramér, de significantietoets aan met een maat voor de sterkte van de samenhang.
De vuistregels van Cohen
De psycholoog Jacob Cohen legde in zijn standaardwerk uit 1988 de basis voor het interpreteren van effectgroottes. Hij stelde richtwaarden voor die tot vandaag als referentie dienen. Belangrijk: het zijn vuistregels, bedoeld als houvast wanneer je geen inhoudelijk ijkpunt hebt, en nadrukkelijk geen absolute grenzen.
| Effectmaat | Klein | Middelgroot | Groot |
|---|---|---|---|
| Cohens d | 0,2 | 0,5 | 0,8 |
| Correlatie r | 0,1 | 0,3 | 0,5 |
| Eta-kwadraat | 0,01 | 0,06 | 0,14 |
| R-kwadraat | 0,02 | 0,13 | 0,26 |
Een Cohens d van 0,5 betekent dat de twee groepsgemiddelden een halve standaarddeviatie uit elkaar liggen. Dat is met het blote oog zichtbaar in de data. Een d van 0,2 is klein maar kan in een grote markt nog steeds commercieel de moeite waard zijn, terwijl een d van 0,8 een verschil is dat vrijwel iedereen opmerkt. Voor Cramérs V hangen de drempels af van het aantal categorieën, wat de interpretatie iets complexer maakt dan bij de andere maten.
De valkuil bij deze tabel is ze mechanisch toepassen. Een klein effect op een uitkomst met enorme schaal, denk aan een fractie procent conversie bij miljoenen bezoekers, kan waardevoller zijn dan een groot effect op een niche. De vuistregels vertellen je hoe groot het effect statistisch is, niet hoeveel het waard is voor jouw business. Die laatste vertaalslag blijft mensenwerk.
Zo bereken je Cohens d: een rekenvoorbeeld
Cohens d is eenvoudig van opzet. Je neemt het verschil tussen de twee gemiddelden en deelt dat door de gepoolde standaarddeviatie, de gecombineerde spreiding van beide groepen. De formule is d = (gemiddelde 1 min gemiddelde 2) gedeeld door de gepoolde standaarddeviatie.
Een voorbeeld uit een tevredenheidsstudie. Je meet de tevredenheid van klanten die via de webshop kochten tegenover klanten die in de winkel kochten. De webshopgroep scoort gemiddeld 7,8 en de winkelgroep 7,4 op een tienpuntsschaal, met een gepoolde standaarddeviatie van 1,5. Het ruwe verschil is 0,4 punt. Gedeeld door 1,5 levert dat een Cohens d op van ongeveer 0,27. Dat is een klein effect. Zelfs als dit verschil bij een grote steekproef statistisch significant zou zijn, is het in de praktijk bescheiden: de twee groepen overlappen sterk.
Bij kleine steekproeven, ruwweg onder twintig respondenten per groep, overschat Cohens d de werkelijke effectgrootte licht. Daarvoor bestaat Hedges g, een gecorrigeerde versie die het effect iets naar beneden bijstelt. Voor de meeste marktonderzoekstudies met honderden respondenten is het verschil tussen d en g verwaarloosbaar, maar het is goed te weten dat de correctie bestaat.
Waarom grote steekproeven de significantie misleiden
Hier ligt de belangrijkste reden waarom effectgrootte onmisbaar is. Statistische significantie hangt sterk af van de steekproefomvang. Hoe groter de steekproef, hoe kleiner het verschil dat je nog als significant kunt aantonen. Bij tienduizend respondenten wordt vrijwel elk verschil, hoe minuscuul ook, statistisch significant.
Dat leidt tot een gevaarlijke situatie. Een bedrijf met een grote klantendatabase meet een verschil van 0,05 punt op een tevredenheidsschaal tussen twee segmenten. Met genoeg respondenten is dat verschil significant, p onder 0,05. Zonder effectgrootte lijkt dat een bevinding. Maar de bijbehorende Cohens d is 0,02, praktisch nul. Er is niets aan de hand, het verschil is ruis die door de omvang van de steekproef zichtbaar werd gemaakt. Wie hierop een strategie bouwt, jaagt spoken na.
De omgekeerde fout komt ook voor. Een klein pilotonderzoek vindt een Cohens d van 0,6, een middelgroot tot groot effect, maar door de kleine steekproef is het net niet significant. Wie enkel naar de p-waarde kijkt, gooit een veelbelovend resultaat weg. De effectgrootte laat zien dat het effect wel degelijk substantieel is en dat een grotere vervolgmeting de moeite loont. Significantie en steekproefomvang en effectgrootte hangen onlosmakelijk samen, en enkel wie alle drie in beeld heeft, trekt de juiste conclusie.
Effectgrootte, steekproef en power: vier grootheden die samenhangen
De grootste bijdrage van Cohen was het inzicht dat vier grootheden onlosmakelijk met elkaar verbonden zijn: de effectgrootte, de steekproefomvang, het significantieniveau (alfa, meestal 0,05) en de power, het onderscheidend vermogen van je toets, oftewel de kans om een effect te vinden dat werkelijk bestaat. Leg je er drie van vast, dan ligt de vierde automatisch vast. Dat maakt effectgrootte niet alleen een uitkomst achteraf, maar ook een instrument vooraf.
| Grootheid | Rol | Typische waarde |
|---|---|---|
| Effectgrootte | Hoe groot het effect is dat je wilt kunnen detecteren | 0,2 / 0,5 / 0,8 (Cohens d) |
| Steekproefomvang | Aantal respondenten in je meting | volgt uit de andere drie |
| Significantieniveau (alfa) | Aanvaarde kans op een vals-positief | 0,05 |
| Power | Kans om een echt effect te vinden | 0,80 |
Voor je begint te meten, schat je de effectgrootte die je minimaal relevant vindt. Uit die schatting, samen met de gewenste power van doorgaans 0,80 en het significantieniveau, rolt het aantal respondenten dat je nodig hebt. Zo voorkom je twee dure vergissingen: een steekproef die te klein is om een relevant effect aan te tonen, en een steekproef die zo groot is dat je betaalt om verschillen te detecteren die er niet toe doen. Effectgrootte is dus zowel het kompas bij het ontwerp van je onderzoek als de meetlat bij de analyse ervan.
Welke effectmaat hoort bij welke toets?
De keuze van de effectmaat volgt logisch uit de analyse die je uitvoert, en die volgt weer uit het meetniveau van je variabelen. Deze tabel koppelt de gangbare toetsen aan de bijbehorende effectmaat.
| Analyse | Vraag | Effectmaat |
|---|---|---|
| T-toets | Verschillen twee gemiddelden? | Cohens d of Hedges g |
| Variantieanalyse | Verschillen drie of meer gemiddelden? | Eta-kwadraat |
| Correlatie | Hangen twee numerieke variabelen samen? | Coëfficiënt r |
| Regressie | Voorspellen variabelen een uitkomst? | R-kwadraat |
| Chi-kwadraattoets | Hangen twee categorieën samen? | Cramérs V |
De praktische regel is simpel: elke toets die een p-waarde produceert, heeft een bijpassende effectmaat, en die twee horen altijd samen gerapporteerd te worden. Statistiekprogramma’s zoals SPSS, R of Jamovi berekenen de meeste effectmaten automatisch of met een aanvinkvakje. Het rekenwerk is dus zelden het probleem. De interpretatie is dat wel.
Waarom effectgrootte interpreteren geen doe-het-zelfklus is
Een effectgrootte laten uitrekenen is een kwestie van een knop indrukken. Moderne software en zelfs AI-assistenten spuwen in seconden een Cohens d of een Cramérs V uit. Juist daardoor daalt de drempel om er verkeerde conclusies aan te verbinden. De rekenmachine maakt het makkelijk om een getal te produceren, maar niet om het juiste getal bij de juiste vraag te kiezen en het correct te duiden.
Waar het misgaat, is bijna nooit de rekensom. Het is de effectmaat kiezen die niet bij het meetniveau past, de vuistregels van Cohen mechanisch toepassen zonder de marktcontext, een klein effect wegwuiven dat op grote schaal goud waard is, of een groot effect overschatten dat op een selectieve, niet representatieve steekproef rust. Een fout geïnterpreteerde effectgrootte is gevaarlijker dan geen effectgrootte, want ze geeft een vals gevoel van precisie. Een cijfer met een decimaal oogt objectief, ook als de conclusie eronder niet klopt.
Daarom loont een onderzoeksbureau zich juist in dit soort werk. De waarde zit niet in de berekening, maar in de vertaalslag van getal naar beslissing: welke maat past, wat betekent 0,3 in jouw markt, en welke actie volgt eruit. Dat is de brug tussen marktonderzoek en strategie, en die bouw je met vakkennis, niet met een formule.
Veelgemaakte fouten bij het gebruik van effectgrootte
Zelfs ervaren analisten glijden uit op een handvol terugkerende fouten. De eerste is enkel de p-waarde rapporteren en de effectgrootte weglaten, waardoor de lezer de omvang van een resultaat niet kan inschatten. De tweede is de vuistregels van Cohen als absolute waarheid behandelen, terwijl ze bedoeld zijn als noodgreep wanneer een inhoudelijk ijkpunt ontbreekt. De derde is de verkeerde maat kiezen voor het meetniveau, bijvoorbeeld Cohens d gebruiken waar Cramérs V hoort. De vierde is een effectgrootte berekenen op een scheve of niet-representatieve steekproef en het resultaat toch doortrekken naar de hele markt. En de vijfde, misschien de sluipendste, is een klein maar reëel effect wegzetten als onbelangrijk zonder de commerciële schaal mee te wegen. Elk van deze fouten levert een rapport op dat cijfermatig klopt maar strategisch de verkeerde kant op wijst.
Effectgrootte rapporteren: praktische richtlijnen
Een goed rapport maakt de effectgrootte even zichtbaar als de significantie. Rapporteer bij elk belangrijk verschil zowel de p-waarde als de effectgrootte, en zet er de interpretatie bij: is dit klein, middelgroot of groot, en wat betekent dat concreet. Vermeld ook het betrouwbaarheidsinterval rond de effectgrootte waar mogelijk, zodat de lezer de onzekerheid ziet.
Vertaal het getal naar de taal van de opdrachtgever. In plaats van enkel te melden dat Cohens d gelijk is aan 0,5, schrijf je dat de tevreden groep gemiddeld een halve standaarddeviatie hoger scoort, een verschil dat in de praktijk duidelijk merkbaar is. Bij een klanttevredenheidsonderzoek of een prijsanalyse is dat het verschil tussen een tabel vol cijfers en een rapport dat een beslissing draagt. De effectgrootte is uiteindelijk geen statistisch sluitstuk, maar het startpunt van de vraag die er echt toe doet: is dit effect groot genoeg om iets mee te doen?
Van cijfer naar beslissing met BABLR
Effectgrootte is de brug tussen een significant resultaat en een verantwoorde beslissing. Ze houdt je weg van triviale bevindingen die groot lijken en helpt je de effecten te vinden die er werkelijk toe doen. Wil je onderzoek dat niet stopt bij de p-waarde maar doorgaat tot de betekenis, ontdek dan de mogelijkheden van BABLR of lees hoe een marktonderzoek bij ons verloopt. Zo weet je niet alleen of iets werkt, maar ook hoeveel.
Veelgestelde vragen over effectgrootte
Effectgrootte is een gestandaardiseerde maat die aangeeft hoe groot een verschil tussen groepen of hoe sterk een samenhang tussen variabelen werkelijk is. Anders dan een p-waarde hangt ze niet af van de steekproefomvang, maar enkel van de data zelf. Daardoor laat ze zien of een gevonden effect ook praktisch betekenisvol is.
Statistische significantie, uitgedrukt in de p-waarde, vertelt of een effect waarschijnlijk niet op toeval berust. Effectgrootte vertelt hoe groot dat effect is. Een resultaat kan statistisch significant zijn en toch verwaarloosbaar klein, zeker bij grote steekproeven. Daarom hoort bij elke significantietoets ook een effectgrootte.
Jacob Cohen stelde in 1988 richtwaarden voor: een d rond 0,2 is een klein effect, rond 0,5 een middelgroot effect en 0,8 of hoger een groot effect. Deze grenzen zijn vuistregels, geen wetten. De praktische betekenis hangt altijd af van de context van je onderzoek en je markt.
Voor het verschil tussen twee gemiddelden deel je het verschil door de gepoolde standaarddeviatie, dat is Cohens d. Voor samenhang tussen twee numerieke variabelen gebruik je de correlatiecoëfficiënt r. Bij variantieanalyse gebruik je eta-kwadraat en bij een kruistabel Cramérs V. Statistische software berekent deze maten meestal automatisch, maar de interpretatie blijft mensenwerk.
Bij een t-toets hoort Cohens d, bij een correlatie de coëfficiënt r, bij regressie R-kwadraat, bij variantieanalyse eta-kwadraat en bij een chi-kwadraattoets Cramérs V. De keuze volgt uit het meetniveau van je variabelen en de vraag die je stelt.
In marktonderzoek stuurt effectgrootte de beslissing. Ze laat zien of een verschil groot genoeg is om erop te investeren, of een campagne echt verschil maakt en welke driver de meeste impact heeft. Zonder effectgrootte verwar je een significant resultaat met een belangrijk resultaat.