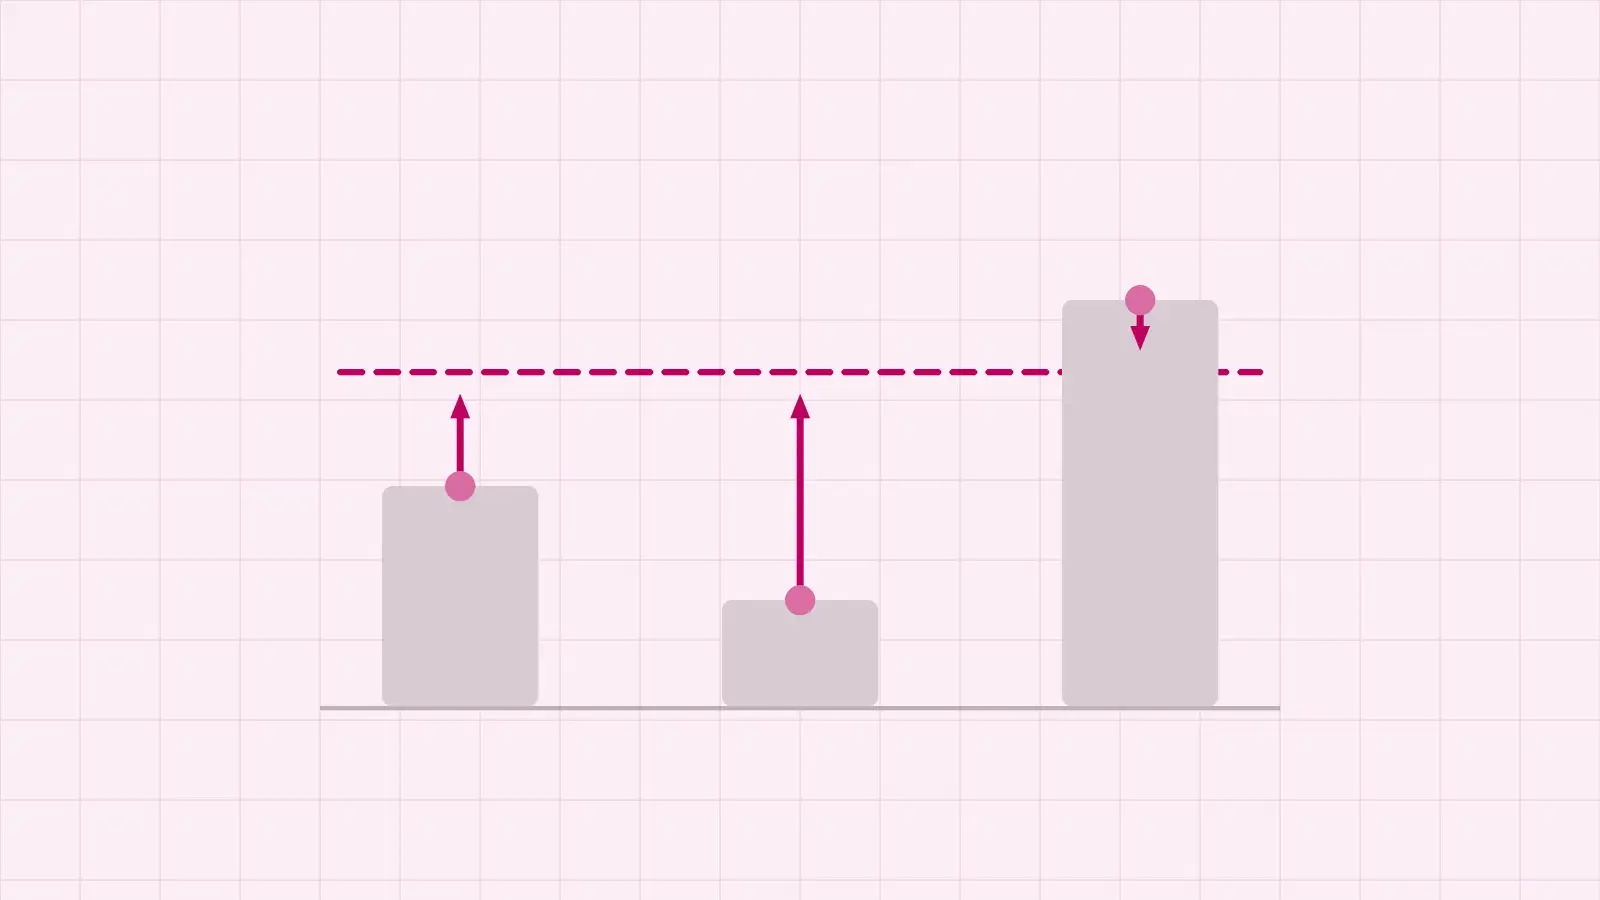
Weging en raking zijn twee statistische correcties waarmee je een scheve steekproef alsnog laat aansluiten op de werkelijke populatie. Bij weging krijgt elke respondent een gewicht: wie tot een ondervertegenwoordigde groep hoort telt zwaarder mee, wie tot een oververtegenwoordigde groep hoort telt lichter. Raking is een iteratieve vorm van weging die alleen de randverdelingen van de populatie nodig heeft en die de gewichten in herhaalde rondes bijstelt tot elke verdeling klopt.
Beide technieken repareren achteraf wat je in het veld liever voorkomt. Ze zijn geen vervanging voor een goede steekproefopzet, en ze hebben een prijs die je moet kennen voor je ze inzet. Hieronder staat hoe je een wegingsfactor berekent, hoe het raking-algoritme werkt, waar het verschil zit en wat weging je kost aan nauwkeurigheid.
Wanneer heb je weging of raking nodig?
Een steekproef wordt vrijwel nooit vanzelf een zuivere afspiegeling van de populatie. De twee oorzaken zijn selectiebias, waarbij bepaalde groepen een kleinere kans hebben om in je steekproef te belanden, en non-respons, waarbij ze wel zijn uitgenodigd maar niet reageren. Jongeren, laagopgeleiden en anderstaligen vallen op die manier structureel uit vragenlijsten weg.
Zolang het om één of twee kenmerken gaat, kun je dat vooraf oplossen met quota in je steekproefmethode. Bij tientallen stratificatievariabelen tegelijk lukt dat niet meer, en extra respondenten werven in de moeilijkste groepen is duur of simpelweg onmogelijk. Jonge deelnemers bereik je bijvoorbeeld beter met methoden die bij een jonge doelgroep passen dan met een hogere uitnodigingsdruk. Wegen en raken zijn dan de rekenkundige uitweg: je herstelt de verhoudingen in de analyse in plaats van in het veld.
Wat is weging en hoe bereken je een wegingsfactor?
Weging, ook post-stratificatie of celweging genoemd, kent elke respondent een gewicht toe zodat de totale steekproef overeenkomt met bekende populatieverdelingen. De formule is eenvoudig:
gewicht = aandeel in de populatie / aandeel in de steekproef
Een groep die ondervertegenwoordigd is krijgt zo een gewicht groter dan 1, een oververtegenwoordigde groep een gewicht kleiner dan 1. Neem een steekproef van 1.000 respondenten waarin de leeftijdsverdeling scheef ligt:
| Leeftijdsgroep | In de steekproef | In de populatie | Gewicht |
|---|---|---|---|
| 18 tot 34 jaar | 60% | 30% | 0,50 |
| 35 tot 54 jaar | 30% | 40% | 1,33 |
| 55 jaar en ouder | 10% | 30% | 3,00 |
Elke jongere telt na weging dus voor een halve respondent en elke 55-plusser voor drie. Reken je het na, dan kloppen de aantallen: 600 maal 0,50 is 300, 300 maal 1,33 is 400 en 100 maal 3,00 is 300. Samen weer 1.000, maar nu in de verhouding 30, 40 en 30 procent.
Werk je met twee of meer kenmerken tegelijk, dan maak je een cel voor elke combinatie. Geslacht maal drie leeftijdsgroepen levert zes cellen op, en per cel bereken je hetzelfde quotiënt. Daarvoor moet je wel de gezamenlijke verdeling van de populatie kennen, dus niet alleen hoeveel vrouwen en hoeveel 55-plussers er zijn, maar hoeveel vrouwen van 55 en ouder.
Wat weging kost aan nauwkeurigheid
Wegen is niet gratis. Hoe verder de gewichten uiteenlopen, hoe kleiner de effectieve steekproefomvang wordt: het aantal respondenten waarmee je statistisch gezien nog werkt. Die bereken je met de formule van Kish:
effectieve n = (som van de gewichten)² / som van de gekwadrateerde gewichten
Toegepast op het voorbeeld hierboven komt de som van de gewichten uit op 1.000 en de som van de kwadraten op 1.583. De effectieve steekproefomvang is dan 1.000² gedeeld door 1.583, ofwel ongeveer 632 respondenten. Je hebt er duizend ondervraagd en je rekent verder met ruim zeshonderd.
Dat zie je terug in de foutmarge. Bij 1.000 waarnemingen en 95 procent betrouwbaarheid is die ongeveer 3,1 procentpunt; bij 632 loopt ze op naar 3,9 procentpunt. De weging maakt je uitkomst representatiever en tegelijk minder precies. Wie het effect op statistische significantie negeert, presenteert verschillen als aangetoond die dat niet zijn.
Wat is raking en hoe werkt het stap voor stap?
Raking, in het Nederlands ook iteratief proportioneel fitten genoemd, lost het probleem op dat celweging bij veel variabelen onwerkbaar wordt. Het algoritme heeft alleen de randverdelingen nodig, dus het percentage mannen, het percentage 55-plussers en het percentage inwoners per regio, en niet de kruisingen daartussen.
De werkwijze verloopt in cycli:
- Geef elke respondent een startgewicht, meestal 1.
- Schaal de gewichten zo dat de verdeling naar geslacht exact overeenkomt met de populatie.
- Schaal daarna zo dat de leeftijdsverdeling klopt. Daarmee raakt de geslachtsverdeling weer licht scheef.
- Doe hetzelfde voor regio, en begin daarna opnieuw bij stap 2.
- Stop zodra alle randverdelingen na een volledige ronde nog maar verwaarloosbaar verschuiven. Dat heet convergentie.
Het algoritme gaat terug op het werk van Deming en Stephan uit 1940 en is sindsdien de standaard bij grootschalige peilingen, onder meer bij Pew Research Center. De aantrekkingskracht zit in de bescheiden datavraag: acht variabelen wegen vraagt bij celweging de volledige kruistabel, bij raking alleen acht rijtjes percentages.
Wat is het verschil tussen weging en raking?
| Aspect | Weging (post-stratificatie) | Raking (iteratief proportioneel fitten) |
|---|---|---|
| Wat het afstemt | De cellen, dus ook alle combinaties van kenmerken | Alleen de randverdeling van elk kenmerk apart |
| Wat je moet weten | De gezamenlijke verdeling van de populatie per cel | Per kenmerk één rij populatiepercentages |
| Hoe je rekent | In één stap: populatieaandeel gedeeld door steekproefaandeel | In herhaalde rondes, tot alle marges kloppen |
| Sterkte | Corrigeert ook de samenhang tussen kenmerken | Blijft werkbaar bij veel kenmerken tegelijk |
| Zwakte | Cellen worden te klein en gewichten te extreem | De kruisingen kunnen scheef blijven |
Kort samengevat: weging is nauwkeuriger maar hongeriger naar data, raking is bescheidener in wat het vraagt en in wat het garandeert.
Wanneer kies je weging en wanneer raking?
Kies celweging als je met hooguit twee of drie kenmerken werkt, de kruistabel van de populatie beschikbaar is en de samenhang tussen die kenmerken inhoudelijk uitmaakt. Denk aan een burgerbevraging waarbij leeftijd en deelgemeente samen bepalen wat iemand vindt.
Kies raking zodra het aantal kenmerken oploopt, de cellen te dun bezet raken of je alleen losse populatiecijfers hebt. In de praktijk komt dat neer op vier kenmerken of meer. Veel onderzoeken combineren beide: eerst design- en non-responsgewichten om ongelijke selectiekansen te compenseren, daarna raking over de resterende kenmerken.
Wat zijn de beperkingen van weging en raking?
Er zijn vier grenzen die je expliciet moet benoemen in je rapportage.
Een ontbrekende groep kun je niet wegen. Zit een doelgroep helemaal niet in je steekproef, dan is er niets om een gewicht aan te hangen. En is een groep met een handvol respondenten vertegenwoordigd, dan blaast een hoog gewicht die paar antwoorden op tot een uitspraak over duizenden mensen. Dat is de harde grens waar geen formule omheen komt. Zie ook hoe je de steekproefgrootte bepaalt voordat je het veld ingaat.
Wegen corrigeert niet binnen een groep. Je herstelt het aandeel 55-plussers, maar niet het verschil tussen de 55-plussers die wél reageerden en zij die zwegen. Als die twee systematisch van elkaar verschillen, blijft de vertekening staan achter een correcte verdeling.
Extreme gewichten vragen om trimmen. Gewichten boven de vijf duwen de effectieve steekproefomvang hard omlaag. De gebruikelijke ingreep is een bovengrens instellen of dun bezette cellen samenvoegen, en dat vervolgens in de verantwoording vermelden.
Je correctie is zo goed als je populatiecijfers. Weeg je op verouderde of geschatte verdelingen, dan reken je je steekproef netjes naar een populatie die niet bestaat. Meer over de plaats van deze stap in het geheel lees je bij data analyseren in marktonderzoek.
Hoe past BABLR weging en raking toe?
Bij BABLR zijn deze correcties onderdeel van de standaardaanpak, niet van een uitzonderingsprocedure. We beginnen met design- en non-responsgewichten, passen post-stratificatie toe op de kenmerken waarvan de kruisverdeling betrouwbaar bekend is, en raken vervolgens over het resterende aantal variabelen. Hoge gewichten trimmen we, en we rapporteren de effectieve steekproefomvang naast het aantal ondervraagden, zodat je ziet met hoeveel gewicht je conclusies werkelijk zijn onderbouwd.
We wegen alleen op variabelen waarvan de populatiecijfers kloppen, en we zeggen het als een subgroep te dun bezet is om er uitspraken aan te hangen. Vragen over representativiteit in je eigen onderzoek? Neem contact op met ons onderzoeksteam.
Veelgestelde vragen over weging en raking
Weging stemt de cellen af, dus ook de combinaties van kenmerken, en vraagt daarvoor de gezamenlijke verdeling van de populatie. Raking stemt alleen de randverdeling van elk kenmerk apart af en heeft per kenmerk maar een rij percentages nodig. Weging is nauwkeuriger, raking blijft werkbaar bij veel kenmerken tegelijk.
Deel het aandeel van een groep in de populatie door het aandeel van diezelfde groep in je steekproef. Is 10 procent van je respondenten 55-plus terwijl die groep 30 procent van de populatie uitmaakt, dan is het gewicht 30 gedeeld door 10, dus 3,00. Elke 55-plusser telt dan voor drie mee.
Nee. Wegen herstelt verhoudingen, geen aantallen. Ontbreekt een groep volledig, dan is er niets om een gewicht aan te hangen. Zit ze er met een handvol respondenten in, dan blaast een hoog gewicht die paar antwoorden op tot een uitspraak over duizenden mensen.
De precisie daalt. Hoe verder de gewichten uiteenlopen, hoe kleiner de effectieve steekproefomvang wordt. Bij een steekproef van 1.000 met gewichten van 0,50 tot 3,00 blijft er effectief ruim 630 over, en loopt de foutmarge op van ongeveer 3,1 naar 3,9 procentpunt.
Nee, en dat is precies de reden om raking te kiezen. Je hebt alleen de losse percentages per kenmerk nodig, bijvoorbeeld het aandeel mannen, het aandeel 55-plussers en het aandeel inwoners per regio. De verdeling van mannen van 55 en ouder hoef je niet te kennen.