De standaardfout (standard error) geeft aan hoe nauwkeurig een uitkomst uit je steekproef de werkelijke waarde in de hele populatie benadert. Je berekent de standaardfout van het gemiddelde door de standaarddeviatie te delen door de wortel van het aantal respondenten (SE = s / √n). Hoe groter je steekproef, hoe kleiner de standaardfout, en dus hoe smaller je foutmarge en betrouwbaarheidsinterval. De standaardfout meet dus geen spreiding tussen respondenten, maar de precisie van je schatting.
In elk kwantitatief onderzoek werk je met een steekproef, niet met de volledige populatie. Je meet een gemiddelde of een percentage bij een paar honderd mensen en je trekt daaruit een conclusie over duizenden of miljoenen. De cruciale vraag is dan: hoe dicht ligt mijn steekproefcijfer bij het echte cijfer? De standaardfout is het getal dat die vraag beantwoordt. Ze is de stille motor achter je foutmarge, je betrouwbaarheidsinterval en elke significantietoets, en toch wordt ze bijna even vaak verkeerd begrepen als correct gebruikt.
In dit artikel leggen we uit wat de standaardfout precies is, waarin ze verschilt van de standaarddeviatie, hoe je ze berekent voor gemiddelden en percentages, en waarom ze bepaalt hoe betrouwbaar je marktonderzoek uiteindelijk is.
Wat is de standaardfout?
De standaardfout is de standaarddeviatie van de steekproevenverdeling. Dat klinkt abstract, dus laten we het concreet maken. Stel dat je een tevredenheidsonderzoek honderd keer zou herhalen, telkens bij een nieuwe, aselecte groep van dezelfde omvang. Elke keer zou je een iets ander gemiddelde krijgen: de ene keer 7,1, de andere keer 7,3, dan weer 7,2. Die gemiddelden vormen samen een verdeling. De standaardfout vertelt je hoe breed die verdeling is, oftewel hoeveel je steekproefgemiddelde van meting tot meting zou schommelen.
In de praktijk doe je het onderzoek natuurlijk maar één keer. Het mooie is dat je de standaardfout toch kunt schatten uit die ene steekproef, zonder het hele onderzoek te herhalen. Je hebt er maar twee dingen voor nodig: de spreiding in je data en het aantal respondenten. De standaardfout is dus geen eigenschap van je respondenten, maar van je schatting. Ze zegt niet hoe verschillend mensen antwoorden, maar hoe zeker je mag zijn van het cijfer dat je rapporteert.
Dat je uit een enkele steekproef toch iets kunt zeggen over al die denkbeeldige herhalingen, komt door een van de stevigste wetten uit de statistiek: de centrale limietstelling. Die zegt dat de steekproefgemiddelden bij een voldoende grote steekproef netjes rond het echte gemiddelde gaan liggen, in een klokvormige verdeling, ongeacht hoe grillig de ruwe antwoorden zelf verdeeld zijn. De standaardfout is precies de breedte van die klok. Daardoor kun je met vaste factoren, zoals 1,96 voor 95 procent, de grenzen rond je schatting afbakenen. Zonder die regelmaat zou elk steekproefcijfer een losse gok blijven.
De standaardfout van het gemiddelde
De meest voorkomende vorm is de standaardfout van het gemiddelde. Je gebruikt ze zodra je een gemiddelde rapporteert: een gemiddelde rapportcijfer, een gemiddelde besteding, een gemiddelde NPS-score. Ze vat in een getal samen hoe precies dat gemiddelde is. Een kleine standaardfout betekent dat je gemiddelde stevig staat, een grote standaardfout betekent dat het nog alle kanten op kan. Daarnaast bestaat de standaardfout van een proportie, die je gebruikt bij percentages. Daarover verderop meer.
Standaardfout versus standaarddeviatie: het verschil dat vaak misgaat
De grootste verwarring in de statistiek zit tussen de standaardfout en de standaarddeviatie. De namen lijken op elkaar, de formules delen een symbool, en toch meten ze iets totaal verschillends. Wie ze door elkaar haalt, rapporteert ofwel een veel te grote spreiding, ofwel een veel te grote schijnzekerheid.
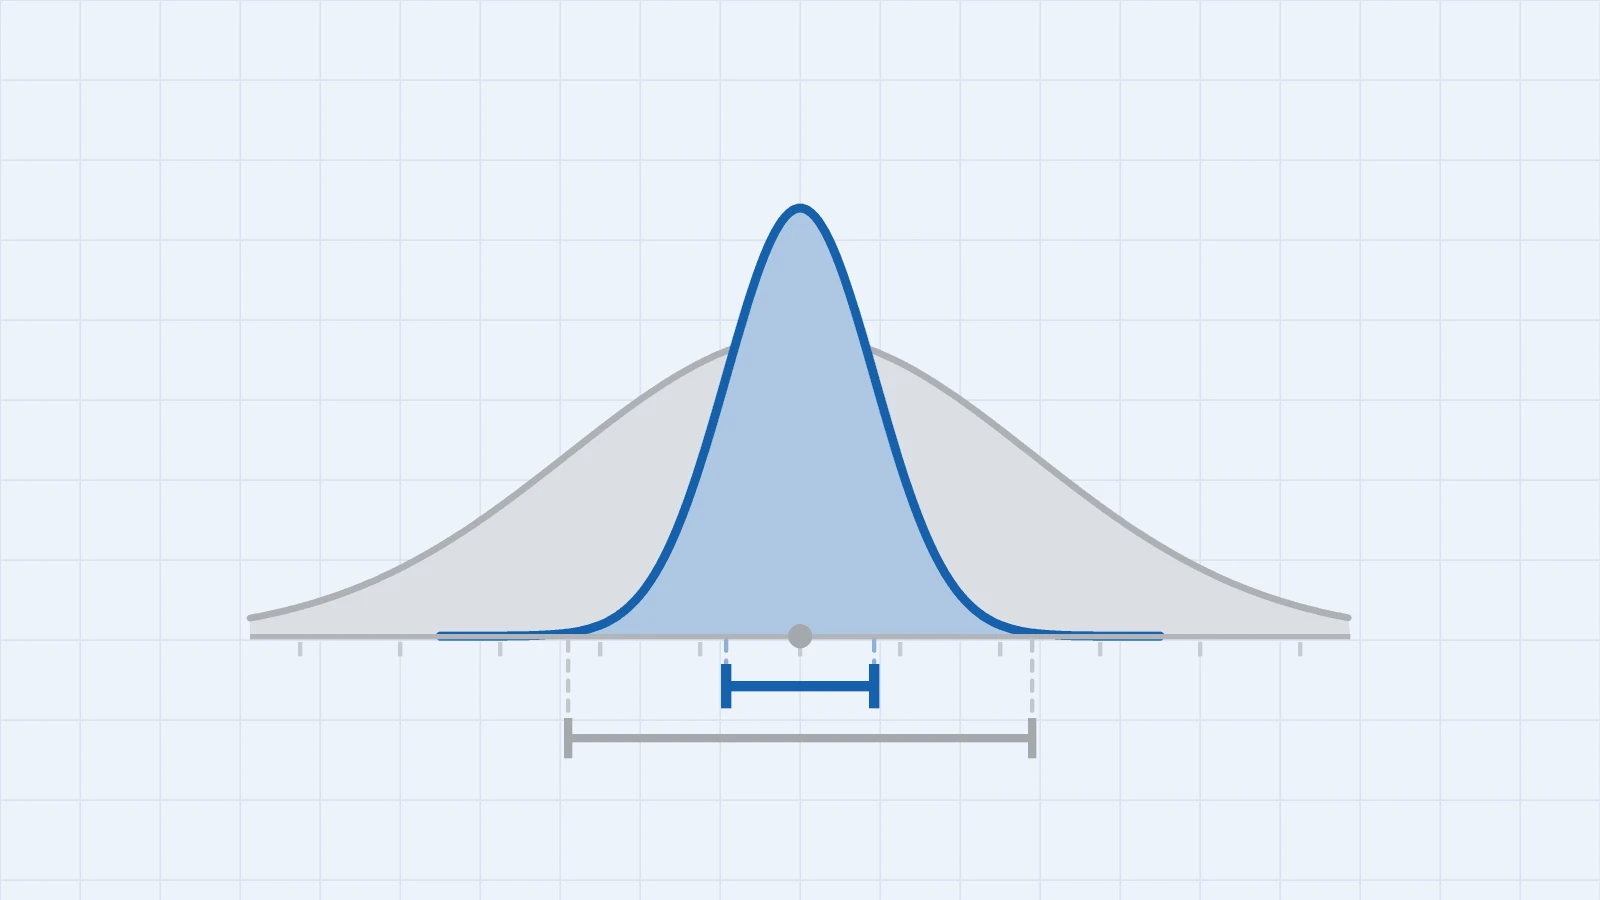
De standaarddeviatie, ook wel de standaardafwijking genoemd, beschrijft de spreiding in je ruwe data: hoe sterk verschillen de individuele respondenten van elkaar? Als klanten rapportcijfers geven van 4 tot 10, is de standaarddeviatie groot. Geven ze allemaal een 7 of 8, dan is ze klein. De standaardfout beschrijft iets anders: de spreiding van je schatting. Ze deelt de standaarddeviatie door de wortel van het aantal respondenten en wordt daardoor altijd kleiner dan de standaarddeviatie zelf. De logica is intuïtief: een gemiddelde van vierhonderd antwoorden schommelt veel minder dan een los antwoord, dus een schatting uit een grote steekproef is preciezer.
Het scharnierpunt zit in de steekproefgrootte. Verdubbel je je steekproef, dan blijft de standaarddeviatie ongeveer gelijk, want mensen blijven even verschillend. De standaardfout daalt wel, want je schatting wordt preciezer. Onderstaande tabel zet de verwante begrippen naast elkaar.
| Begrip | Wat het meet | Formule (gemiddelde) | Hangt af van de steekproefgrootte? |
|---|---|---|---|
| Standaarddeviatie (s) | Spreiding tussen individuele respondenten | s | Nee |
| Variantie (s²) | Het kwadraat van de standaarddeviatie | s² | Nee |
| Standaardfout (SE) | Precisie van de steekproefschatting | s / √n | Ja |
| Foutmarge | Halve breedte van het betrouwbaarheidsinterval | z × SE | Ja |
| Betrouwbaarheidsinterval | Bereik waarin de echte waarde vermoedelijk ligt | schatting ± z × SE | Ja |
Kort samengevat: gebruik de standaarddeviatie als je wil tonen hoe verschillend je respondenten zijn, en de standaardfout als je wil tonen hoe betrouwbaar je cijfer is. Dat onderscheid is geen muggenzifterij, het bepaalt of je conclusie klopt.
Hoe bereken je de standaardfout?
De formule voor de standaardfout van het gemiddelde is eenvoudig: deel de standaarddeviatie van je steekproef door de wortel van het aantal respondenten. Een voorbeeld maakt het concreet. Stel, je meet de klanttevredenheid bij honderd klanten op een schaal van 0 tot 10. Het gemiddelde is 7,2 en de standaarddeviatie is 1,5. De standaardfout is dan 1,5 gedeeld door de wortel van 100, dus 1,5 gedeeld door 10, wat 0,15 oplevert.
Die 0,15 vertelt je iets belangrijks: het echte populatiegemiddelde ligt vrijwel zeker heel dicht bij 7,2. Zou de standaardfout 0,6 zijn geweest, dan was je cijfer veel wankeler. Met deze ene waarde kun je meteen door naar de foutmarge en het betrouwbaarheidsinterval, de twee getallen die je uiteindelijk rapporteert.
De standaardfout van een proportie
Bij percentages gebruik je een andere formule. Als 40 procent van vierhonderd respondenten tevreden is, bereken je de standaardfout als de wortel van (0,40 maal 0,60 gedeeld door 400). Dat is de wortel van 0,0006, oftewel ongeveer 0,0245 of 2,45 procentpunt. De foutmarge bij 95 procent betrouwbaarheid is dan 1,96 maal 2,45, dus ongeveer 4,8 procentpunt. Je rapporteert dan: 40 procent tevreden, met een foutmarge van bijna 5 procentpunt. Onderstaande tabel vat de drie meest gebruikte vormen samen.
| Grootheid | Formule standaardfout | Wanneer gebruik je ze? |
|---|---|---|
| Gemiddelde | s / √n | Gemiddelde scores, bedragen, rapportcijfers |
| Proportie (percentage) | √(p × (1 − p) / n) | Aandeel tevreden klanten, marktaandeel, ja-nee-vragen |
| Verschil tussen twee gemiddelden | √(SE1² + SE2²) | Vergelijking van twee groepen of twee metingen |
Die derde vorm is de noemer van de t-toets: je deelt het verschil tussen twee gemiddelden door de standaardfout van dat verschil. In Excel reken je de standaardfout van het gemiddelde eenvoudig uit door de functie STDEV te delen door de wortel van het aantal waarnemingen, bijvoorbeeld STDEV(bereik) gedeeld door WORTEL(AANTAL(bereik)). Statistische software zoals SPSS, R of Python toont de standaardfout standaard bij elke schatting. Juist omdat het getal er zo kant-en-klaar bijstaat, is het verleidelijk om het over te nemen zonder te controleren of de aannames kloppen.
Waarom de standaardfout je foutmarge en betrouwbaarheidsinterval bepaalt
De standaardfout is op zich een tussenresultaat. Wat je echt wil weten, is binnen welke grenzen de werkelijke waarde ligt. Daarvoor vermenigvuldig je de standaardfout met een factor die hoort bij je gekozen betrouwbaarheidsniveau. Voor 95 procent betrouwbaarheid is die factor ongeveer 1,96, voor 90 procent ongeveer 1,65 en voor 99 procent ongeveer 2,58. Het resultaat is de foutmarge.
Terug naar ons voorbeeld. Bij een gemiddelde van 7,2 en een standaardfout van 0,15 is de foutmarge bij 95 procent betrouwbaarheid gelijk aan 1,96 maal 0,15, dus ongeveer 0,29. Het betrouwbaarheidsinterval loopt dan van 6,91 tot 7,49. In gewone taal: je mag er met 95 procent zekerheid van uitgaan dat het echte gemiddelde in de populatie ergens tussen 6,91 en 7,49 ligt. Zonder de standaardfout kun je dat interval niet berekenen, en zonder dat interval is een gemiddelde niet meer dan een los getal zonder foutgrenzen.
Dezelfde standaardfout zit ook onder elke significantietoets. Of een verschil tussen twee groepen echt is of toeval, hangt af van hoe groot dat verschil is in verhouding tot de standaardfout van dat verschil. Een verschil van 0,4 punt is overtuigend bij een standaardfout van 0,1, maar nietszeggend bij een standaardfout van 0,5. Wie de uitkomst van een toets wil begrijpen, moet dus eerst de standaardfout begrijpen. Zie ook ons artikel over statistische significantie voor hoe die stap verder verloopt, en over effectgrootte voor de vraag die daarna komt: hoe groot is het verschil eigenlijk?
Dit verklaart ook waarom je bij een peiling vaak een foutmarge van enkele procentpunten ziet terugkomen. Die marge is niets anders dan de standaardfout van een proportie, vermenigvuldigd met de betrouwbaarheidsfactor. Een peiling onder duizend kiezers geeft bij een percentage rond de 50 procent een foutmarge van ongeveer 3 procentpunt. Ligt een partij op 20 procent, dan zakt die marge naar ongeveer 2,5 procentpunt, want de teller p maal 1 min p is daar kleiner. In beide gevallen betekent een verschuiving van een procentpunt tussen twee peilingen dus weinig: ze valt ruim binnen de ruis. Precies daarom hoor je onderzoekers zelden spreken over een verschil zonder het in de context van de foutmarge te plaatsen. Rapporteer je een cijfer zonder foutmarge, dan laat je je lezer niet zien hoe hard of hoe zacht het eigenlijk is.
Wanneer is de standaardfout groot of klein?
De standaardfout wordt door precies twee dingen gedreven: de spreiding in je data en het aantal respondenten. Veel spreiding maakt de standaardfout groter, een grote steekproef maakt ze kleiner. Aan de spreiding kun je weinig veranderen, die zit nu eenmaal in je doelgroep. Aan de steekproefgrootte wel, en daar zit de belangrijkste les.
Omdat je door de wortel van het aantal respondenten deelt, loont elke extra respondent steeds minder. Om de standaardfout te halveren, heb je niet twee keer maar vier keer zoveel respondenten nodig. Onderstaande tabel laat dat zien voor een standaarddeviatie van 1,5.
| Aantal respondenten (n) | √n | Standaardfout (s / √n) | Foutmarge bij 95% (1,96 × SE) |
|---|---|---|---|
| 25 | 5 | 0,30 | 0,59 |
| 100 | 10 | 0,15 | 0,29 |
| 400 | 20 | 0,075 | 0,15 |
| 1600 | 40 | 0,0375 | 0,07 |
Van 100 naar 400 respondenten halveert de standaardfout, en dus ook de foutmarge. Maar van 400 naar 1600 moet je er alweer twaalfhonderd respondenten bij halen voor diezelfde halvering. Op een bepaald punt wordt een smallere foutmarge dus onbetaalbaar in verhouding tot wat ze oplevert. Dat is precies de afweging die je maakt bij het bepalen van je steekproefgrootte: je kiest je aantal respondenten op basis van de foutmarge die je nog acceptabel vindt, niet op basis van zoveel mogelijk. We werken die afweging volledig uit in onze gids over de steekproefgrootte bepalen.
Vijf valkuilen rond de standaardfout
Elke enquêtetool en elk statistiekpakket rekent de standaardfout vandaag automatisch uit. Dat is handig, maar het heeft een keerzijde: het getal verschijnt zonder dat iemand controleert of het betekenisvol is. De drempel om een standaardfout te produceren is tot nul gedaald, maar de drempel om er een verkeerde conclusie uit te trekken net zo goed. Juist daarom loont het om een onderzoeker naar je cijfers te laten kijken. Dit zijn de vijf fouten die we het vaakst zien.
Die laatste valkuil is de meest sluipende. De formule voor de standaardfout gaat ervan uit dat je steekproef aselect en representatief is. Is ze dat niet, dan geeft de standaardfout een keurige, smalle foutmarge rond een cijfer dat gewoon scheef is. Je rapporteert dan precisie zonder juistheid. Daarom begint een betrouwbaar resultaat niet bij de formule, maar bij een zuivere steekproefmethode en, waar nodig, correcte weging en raking. Pas als de steekproef klopt, zegt de standaardfout iets zinnigs.
Van standaardfout naar betrouwbare conclusies
De standaardfout is een klein getal met een grote rol. Ze vertaalt de ruwe spreiding in je data en de omvang van je steekproef naar een maat voor precisie, en vormt zo de brug naar je foutmarge, je betrouwbaarheidsinterval en je significantietoetsen. Wie het verschil met de standaarddeviatie begrijpt en weet dat de steekproefgrootte via de wortel van n de precisie stuurt, leest cijfers meteen scherper. Ze maakt ook meteen duidelijk waarom goede dataverzameling en een nette steekproef geen formaliteit zijn, maar de voorwaarde waaronder al die statistiek pas betekenis krijgt.
Bij BABLR vertalen we dit soort statistiek naar beslissingen waar je echt op kunt bouwen. Van de opzet van je steekproef tot de interpretatie van de resultaten zorgen we dat je cijfers niet alleen precies ogen, maar ook kloppen. Bekijk onze soorten marktonderzoek of ontdek hoe een marktonderzoek via BABLR verloopt, en lees meer over de meest gebruikte statistische technieken die we inzetten. Of je nu werkt aan klanttevredenheidsonderzoek, consumentenonderzoek of B2B-marktonderzoek, wij zorgen dat de standaardfout in je voordeel werkt. Wil je dieper graven in de cijfers zelf, lees dan onze artikels over correlatie en causaliteit en datavisualisatie, of ontdek het verschil tussen kwalitatief en kwantitatief onderzoek en de bredere context in onze gids over marktonderzoek.
Veelgestelde vragen over de standaardfout
De standaardfout geeft aan hoe nauwkeurig een uitkomst uit je steekproef de werkelijke waarde in de populatie benadert. Ze meet dus niet de spreiding tussen respondenten, maar de precisie van je schatting. Je berekent de standaardfout van het gemiddelde door de standaarddeviatie te delen door de wortel van het aantal respondenten.
De standaarddeviatie beschrijft hoe sterk de individuele antwoorden onderling verschillen. De standaardfout beschrijft hoe sterk het gemiddelde van je steekproef zou variëren als je het onderzoek telkens opnieuw zou herhalen. De standaarddeviatie blijft ongeveer gelijk bij een grotere steekproef, de standaardfout wordt kleiner.
Deel de standaarddeviatie van je steekproef door de wortel van het aantal respondenten. Bij een standaarddeviatie van 1,5 en 100 respondenten is de standaardfout 1,5 gedeeld door 10, dus 0,15. In Excel bereken je ze door STDEV te delen door de wortel van het aantal waarnemingen.
Omdat je deelt door de wortel van het aantal respondenten, en die wortel is bij meer dan één respondent altijd groter dan één. Het gemiddelde van veel antwoorden schommelt minder dan een los antwoord, dus een schatting op basis van een steekproef is preciezer dan een enkele waarneming.
De standaardfout is groot bij veel spreiding in de antwoorden of een kleine steekproef. Ze is klein bij weinig spreiding of een grote steekproef. Omdat je door de wortel van n deelt, kost elke verdubbeling van de precisie ongeveer vier keer zoveel respondenten.
De foutmarge is de standaardfout vermenigvuldigd met een factor die hoort bij je betrouwbaarheidsniveau, voor 95 procent is dat ongeveer 1,96. Een kleinere standaardfout geeft dus een smallere foutmarge en een nauwkeuriger betrouwbaarheidsinterval.