De normaalverdeling is een symmetrische, klokvormige kansverdeling waarbij de meeste waarnemingen dicht bij het gemiddelde liggen en extreme waarden zeldzaam zijn. In marktonderzoek is ze belangrijk omdat veel analysetechnieken, van betrouwbaarheidsintervallen tot significantietoetsen, ervan uitgaan dat gegevens of steekproefgemiddelden bij benadering normaal verdeeld zijn. Twee getallen beschrijven de curve volledig: het gemiddelde bepaalt waar de top ligt, de standaarddeviatie bepaalt hoe breed ze is.
Wie met cijfers uit een enquête werkt, botst vroeg of laat op de normaalverdeling. Ze zit verstopt onder de motorkap van bijna elke berekening die een onderzoeksbureau maakt, van de foutmarge op een tevredenheidsscore tot de vraag of twee doelgroepen echt verschillen. Toch blijft het begrip voor veel opdrachtgevers abstract. In dit artikel leggen we uit wat een normaalverdeling is, hoe je ze leest, waarom ze zo centraal staat in de statistische technieken van marktonderzoek, en vooral waar het in de praktijk misloopt.
Wat is een normaalverdeling?
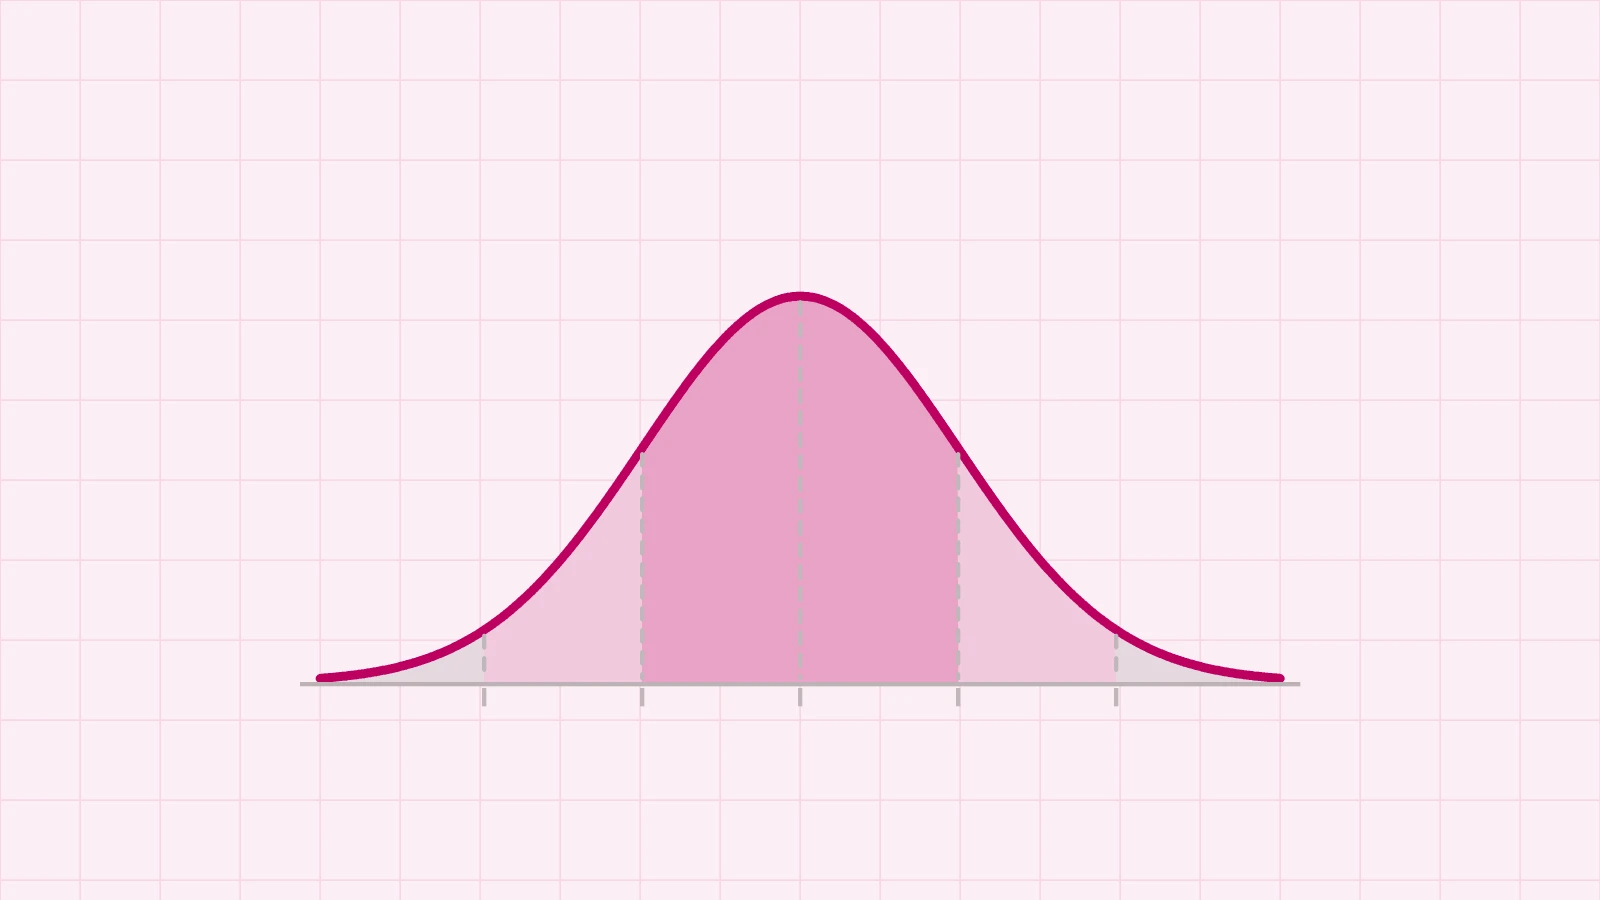
Een normaalverdeling, ook wel normale verdeling of gausscurve genoemd, beschrijft hoe waarden van een variabele zich rond een gemiddelde spreiden. Teken je de verdeling, dan krijg je de bekende klokvorm: een hoge piek in het midden en twee staarten die symmetrisch naar beneden lopen. Hoe verder je van het gemiddelde af zit, hoe zeldzamer de waarde. Bij een perfecte normaalverdeling vallen het gemiddelde, de mediaan en de modus allemaal samen in het midden.
De vorm wordt volledig vastgelegd door twee parameters. Het gemiddelde bepaalt waar het hoogtepunt van de klok ligt. De standaarddeviatie, een maat voor spreiding, bepaalt hoe breed of smal de klok is. Een kleine standaarddeviatie geeft een slanke, hoge curve: de waarnemingen liggen dicht op elkaar. Een grote standaarddeviatie geeft een brede, platte curve: de waarnemingen liggen ver uit elkaar. Daarom zeggen een gemiddelde en een standaarddeviatie samen veel meer dan een gemiddelde alleen.
De verdeling heeft diepe wortels. De Moivre beschreef de klokvorm al in 1733 als benadering van kansrekening, Gauss gebruikte ze rond 1809 om meetfouten in sterrenkundige waarnemingen te modelleren, en Quetelet paste ze in de negentiende eeuw toe op menselijke kenmerken zoals lengte. Dat idee, dat natuurlijke variatie zich vaak rond een gemiddelde ophoopt, verklaart waarom de curve ook in marktonderzoek telkens opduikt.
De 68-95-99,7-regel
De kracht van de normaalverdeling zit in haar voorspelbaarheid. Zodra je weet dat een variabele bij benadering normaal verdeeld is, weet je meteen hoeveel waarnemingen binnen een bepaald bereik rond het gemiddelde vallen. Dat vat de empirische regel samen, ook wel de 68-95-99,7-regel genoemd.
| Bereik rond het gemiddelde | Aandeel van de waarnemingen | Betekenis |
|---|---|---|
| Een standaarddeviatie (plus en min) | Ongeveer 68 procent | De gewone middenmoot |
| Twee standaarddeviaties | Ongeveer 95 procent | De basis voor het klassieke betrouwbaarheidsinterval |
| Drie standaarddeviaties | Ongeveer 99,7 procent | Vrijwel alles, buiten de zeldzame uitschieters |
Een concreet voorbeeld maakt dit tastbaar. Stel dat de tevredenheidsscore in een klanttevredenheidsonderzoek gemiddeld 7,2 bedraagt met een standaarddeviatie van 0,8 op een schaal van 0 tot 10. Als die scores bij benadering normaal verdeeld zijn, ligt ongeveer 68 procent van de klanten tussen 6,4 en 8,0, ongeveer 95 procent tussen 5,6 en 8,8, en vrijwel iedereen tussen 4,8 en 9,6. Een losse klant die een 4 geeft, valt dus buiten drie standaarddeviaties: een echte uitzondering die aandacht verdient, geen ruis.
Van ruwe score naar z-score
Om scores onderling te kunnen vergelijken, zetten onderzoekers een waarde om naar een z-score. De formule is eenvoudig: trek het gemiddelde van de waarde af en deel door de standaarddeviatie. Een z-score van 0 betekent precies gemiddeld, een z-score van plus 2 betekent twee standaarddeviaties boven het gemiddelde. Zet je elke waarde om, dan krijg je de standaardnormale verdeling, een normaalverdeling met gemiddelde 0 en standaarddeviatie 1. Die standaardvorm maakt het mogelijk om kansen op te zoeken en om variabelen met verschillende schalen eerlijk naast elkaar te leggen.
Een herkenbaar voorbeeld: IQ-scores
Het bekendste voorbeeld van een normaalverdeling is de IQ-score. Die is bewust zo opgezet dat het gemiddelde op 100 ligt met een standaarddeviatie van 15. Via de empirische regel weet je dan meteen dat ongeveer 68 procent van de mensen een IQ tussen 85 en 115 heeft, en ongeveer 95 procent tussen 70 en 130. Dat is precies de logica die marktonderzoekers toepassen op gestandaardiseerde scores, bijvoorbeeld bij een merkimago-index of een gestandaardiseerde tevredenheidsschaal. Je maakt scores vergelijkbaar door ze om te rekenen naar een vaste schaal met een bekend gemiddelde en een bekende spreiding, en de normaalverdeling levert de vertaaltabel tussen score en percentiel.
Waarom de normaalverdeling centraal staat in marktonderzoek
De normaalverdeling is geen academisch detail. Ze is de stille aanname onder een groot deel van de kwantitatieve analyse. Drie toepassingen springen eruit.
Ten eerste de foutmarge. Wanneer je rapporteert dat een merk bekend is bij 42 procent van de markt, met een foutmarge van plus of min 3 procent, dan rust die marge op de normaalverdeling. De beroemde z-waarde van 1,96 bij 95 procent betrouwbaarheid komt rechtstreeks uit de klokvorm. Hoe je die marge en de bijbehorende steekproef bepaalt, lees je in ons artikel over de steekproefgrootte bepalen.
Ten tweede de significantietoets. Of een gemeten verschil tussen twee groepen echt is of toeval, beoordeel je door het af te zetten tegen wat je op basis van een normaalverdeling zou verwachten. De logica achter die beslissing beschrijven we in statistische significantie.
Ten derde de vergelijkbaarheid. Omdat de curve een vaste vorm heeft, kun je verschillende metingen op dezelfde meetlat leggen en netjes visualiseren. Zo wordt een abstracte spreiding een beeld dat een directie in een oogopslag begrijpt.
De centrale limietstelling
Hier schuilt de belangrijkste reden waarom de normaalverdeling zo vaak opduikt, ook als de ruwe data zelf niet normaal is. De centrale limietstelling zegt dat de verdeling van steekproefgemiddelden bij benadering normaal wordt naarmate de steekproef groter wordt, ongeacht de vorm van de oorspronkelijke populatie. Als vuistregel geldt vaak een steekproef van minstens dertig waarnemingen, al hangt het exacte getal af van hoe scheef de data is.
Dat is geen theoretische voetnoot maar het fundament van bijna alle enquêteonderzoek. Je meet nooit de hele markt, je werkt met een steekproef. De centrale limietstelling verzekert dat het gemiddelde van die steekproef een voorspelbare verdeling volgt, zodat je er een betrouwbaarheidsinterval omheen kunt leggen. De spreiding van die steekproefgemiddelden heet de standaardfout, en die wordt kleiner naarmate de steekproef groeit. Grotere steekproeven geven dus smallere, betrouwbaardere schattingen. Of je steekproef ook representatief is voor de populatie, blijft een aparte voorwaarde: lees daarvoor representativiteit waarborgen met weging en raking.
De normaalverdeling is trouwens typisch een begrip uit de kwantitatieve hoek van onderzoek, waar je in cijfers en spreidingen denkt. In kwalitatief onderzoek, met diepte-interviews en focusgroepen, speelt ze geen rol. Het onderscheid tussen beide sporen lees je in het verschil tussen kwalitatief en kwantitatief marktonderzoek. Precies omdat de curve zo vaak impliciet wordt verondersteld, loont het om te weten wanneer ze wel en niet van toepassing is.
Hoe verhoudt de normaalverdeling zich tot andere verdelingen?
Niet elke variabele volgt de klokvorm. De normaalverdeling is de bekendste, maar ze is er een uit een familie. Wie de verschillen kent, kiest sneller de juiste analyse en vermijdt de reflex om alles door de normale bril te bekijken.
| Verdeling | Vorm | Typisch in marktonderzoek |
|---|---|---|
| Normaalverdeling | Symmetrische klok | Steekproefgemiddelden, meetfouten, veel attitudescores |
| Uniforme verdeling | Vlak, elke waarde even waarschijnlijk | Toevalsgetallen, willekeurige toewijzing |
| Rechtsscheve verdeling | Lange staart naar rechts | Inkomen, bestelwaarde, klantwaarde |
| t-verdeling | Klok met dikkere staarten | Toetsen bij kleine steekproeven |
| Categorische verdeling | Losse categorieën, geen gemiddelde | Merkkeuze, ja-of-nee-conversie |
De t-verdeling verdient een korte toelichting, want ze lijkt sterk op de normaalverdeling maar heeft dikkere staarten. Die extra ruimte in de staarten houdt rekening met de grotere onzekerheid bij kleine steekproeven. Naarmate de steekproef groeit, kruipt de t-verdeling dichter naar de normaalverdeling toe. Daarom werken onderzoekers bij een beperkt aantal respondenten vaak met de t-verdeling, en pas bij grote steekproeven met de zuivere normaalverdeling. De categorische verdeling staat dan weer helemaal los van de klok: bij een keuze tussen merken bestaat er geen gemiddelde, en gebruik je samenhangstoetsen in plaats van gemiddelden. Dat soort afwegingen keert terug in elke degelijke marktanalyse en in B2B-marktonderzoek, waar steekproeven vaak kleiner en schever zijn dan in consumentenstudies.
Normaalverdeling herkennen en controleren
Voor je een techniek toepast die normaliteit veronderstelt, loont het om te controleren of je data die aanname redelijk benadert. Dat doe je op drie niveaus: eerst met je ogen, dan met kengetallen, en pas daarna met een formele toets.
| Methode | Wat je bekijkt | Let op |
|---|---|---|
| Histogram | Of de vorm klokachtig en symmetrisch is | Snel en intuïtief, maar gevoelig voor de gekozen klassenbreedte |
| Q-Q-plot | Of de punten op een rechte lijn liggen | Krachtiger dan een histogram, vraagt wat oefening in het lezen |
| Scheefheid en kurtosis | Getallen voor asymmetrie en piekvorm | Bij nul scheefheid is de verdeling symmetrisch |
| Shapiro-Wilk-toets | Een formele toets op normaliteit | Slaat bij grote steekproeven al aan op minieme afwijkingen |
De laatste regel verdient nadruk. Een formele normaliteitstoets lijkt objectief, maar bij een grote steekproef verwerpt ze de normaalverdeling bijna altijd, ook als de afwijking voor je conclusie totaal onbelangrijk is. Een ervaren onderzoeker weegt daarom de visuele controle, de getallen en de toets samen, in plaats van blind op een p-waarde te varen. Normaliteit is zelden perfect, de vraag is of de afwijking groot genoeg is om je resultaat te vertekenen.
Een praktische tip: controleer niet alleen de ruwe variabele, maar ook de grootheid die je uiteindelijk toetst. Bij een vergelijking van gemiddelden tussen twee groepen is het de verdeling van die groepsgemiddelden die telt, en dankzij de centrale limietstelling is die vaak al veel netter dan de onderliggende data. Zo voorkom je dat je een analyse onnodig verwerpt op basis van een scheve ruwe variabele die in de praktijk geen probleem vormt.
Wanneer je data niet normaal verdeeld is
Veel variabelen in marktonderzoek zijn van nature scheef. Dat is geen fout, het is de werkelijkheid. Inkomen, bestelwaarde, wachttijd en klantwaarde zijn vrijwel altijd rechtsscheef: de meeste mensen zitten laag, een kleine groep torent hoog uit en trekt het gemiddelde omhoog. Bij zulke verdelingen is de mediaan een eerlijker middenmaat dan het gemiddelde. Ook de verdeling van NPS-scores of een tevredenheidsscore met een plafond van 10 botst vaak tegen de rand en wordt daardoor scheef.
| Situatie | Typisch voorbeeld | Wat je doet |
|---|---|---|
| Rechtsscheve data | Inkomen, bestelwaarde, klantwaarde | Mediaan rapporteren, of een logtransformatie toepassen |
| Plafond of bodem | Scores op een schaal van 0 tot 10 | Voorzichtig interpreteren, grenseffecten benoemen |
| Kleine steekproef en scheef | Niche-B2B-onderzoek | Niet-parametrische toets gebruiken |
| Categorische data | Keuze tussen merken | Chi-kwadraat in plaats van een gemiddelde |
Er zijn dus altijd uitwegen. Je kunt de data transformeren, bijvoorbeeld met een logaritme, zodat de verdeling symmetrischer wordt. Je kunt overstappen op niet-parametrische technieken die geen normaalverdeling veronderstellen. En voor variabelen die helemaal geen gemiddelde kennen, zoals een keuze tussen merken, gebruik je een heel andere aanpak, bijvoorbeeld de chi-kwadraattoets. Welke route past, hangt af van het meetniveau en de onderzoeksvraag, een afweging die ook terugkomt bij clusteranalyse en andere meervoudige technieken.
Vijf valkuilen bij de normaalverdeling
Moderne software rekent een gemiddelde, een standaarddeviatie en een significantietoets in een tel uit, en AI-assistenten spuwen in seconden een conclusie uit. Dat is handig, maar het verbergt een probleem: de tool controleert zelden of de normaalverdeling wel geldt, en levert ook dan een keurig ogend getal af. De drempel om een fout onderzoek te maken daalt juist nu de rekenkracht toeneemt. Precies daarom heb je iemand nodig die de aannames bewaakt. Deze vijf valkuilen zien we het vaakst.
De rode draad: de normaalverdeling is een krachtig model, maar het blijft een model. De werkelijkheid van marktonderzoek is rommeliger dan een gladde klokcurve. Scores uit een consumentenonderzoek lopen tegen hun plafond aan, bestedingen zijn scheef, en een uitschieter is soms het interessantste wat je die week meet. Het verschil tussen een correcte en een misleidende analyse zit niet in de rekenstap, dat deel doet de computer, maar in het oordeel ervoor en erna. Dat oordeel bepaalt of een cijfer een betrouwbare basis voor een beslissing wordt, of een dure vergissing.
Conclusie
De normaalverdeling is de klokvormige curve waarop een groot deel van het kwantitatieve marktonderzoek rust. Ze vat spreiding samen in twee getallen, voorspelt via de 68-95-99,7-regel hoe uitzonderlijk een waarde is, en maakt via de centrale limietstelling betrouwbare schattingen uit een steekproef mogelijk. Maar de curve is een aanname, geen garantie. Veel marktonderzoeksdata is scheef, en wie dat negeert, bouwt conclusies op drijfzand. De waarde van een goede onderzoekspartner zit juist in het bewaken van die aannames, zodat de cijfers kloppen en de beslissing erop kan rusten.
Wil je zeker weten dat jouw cijfers op de juiste manier geanalyseerd worden? Ontdek wat de verschillende soorten marktonderzoek van BABLR voor jouw organisatie kunnen betekenen, of het nu gaat om een eenmalige meting of een doorlopend programma.
Veelgestelde vragen over de normaalverdeling
Een normaalverdeling is een symmetrische, klokvormige kansverdeling waarbij de meeste waarnemingen dicht bij het gemiddelde liggen en extreme waarden zeldzaam zijn. Ze wordt volledig beschreven door twee getallen: het gemiddelde (waar de top ligt) en de standaarddeviatie (hoe breed de curve is).
De empirische regel zegt dat bij een normaalverdeling ongeveer 68 procent van de waarnemingen binnen een standaarddeviatie van het gemiddelde valt, ongeveer 95 procent binnen twee standaarddeviaties en ongeveer 99,7 procent binnen drie. Daarmee schat je snel hoe uitzonderlijk een score is.
Veel courante technieken, zoals betrouwbaarheidsintervallen en significantietoetsen, gaan ervan uit dat gegevens of steekproefgemiddelden bij benadering normaal verdeeld zijn. De curve bepaalt mee hoeveel respondenten je nodig hebt en hoe betrouwbaar een gemeten verschil is.
Nee. Veel marktonderzoeksdata is scheef, denk aan inkomen, bestelwaarde of wachttijd. Dankzij de centrale limietstelling worden steekproefgemiddelden toch bij benadering normaal zodra de steekproef groot genoeg is. Voor sterk scheve data gebruik je een transformatie of een niet-parametrische toets.
De standaardnormale verdeling is een normaalverdeling met gemiddelde 0 en standaarddeviatie 1. Je zet elke normaalverdeling om naar deze standaardvorm met een z-score, zodat je waarden onderling kunt vergelijken en kansen kunt opzoeken.
Begin visueel met een histogram of een Q-Q-plot en kijk naar de scheefheid. Vul dit aan met een toets zoals Shapiro-Wilk. Combineer de uitkomsten altijd met je kennis van de variabele, want bij grote steekproeven slaat een toets al bij kleine, onbelangrijke afwijkingen aan.