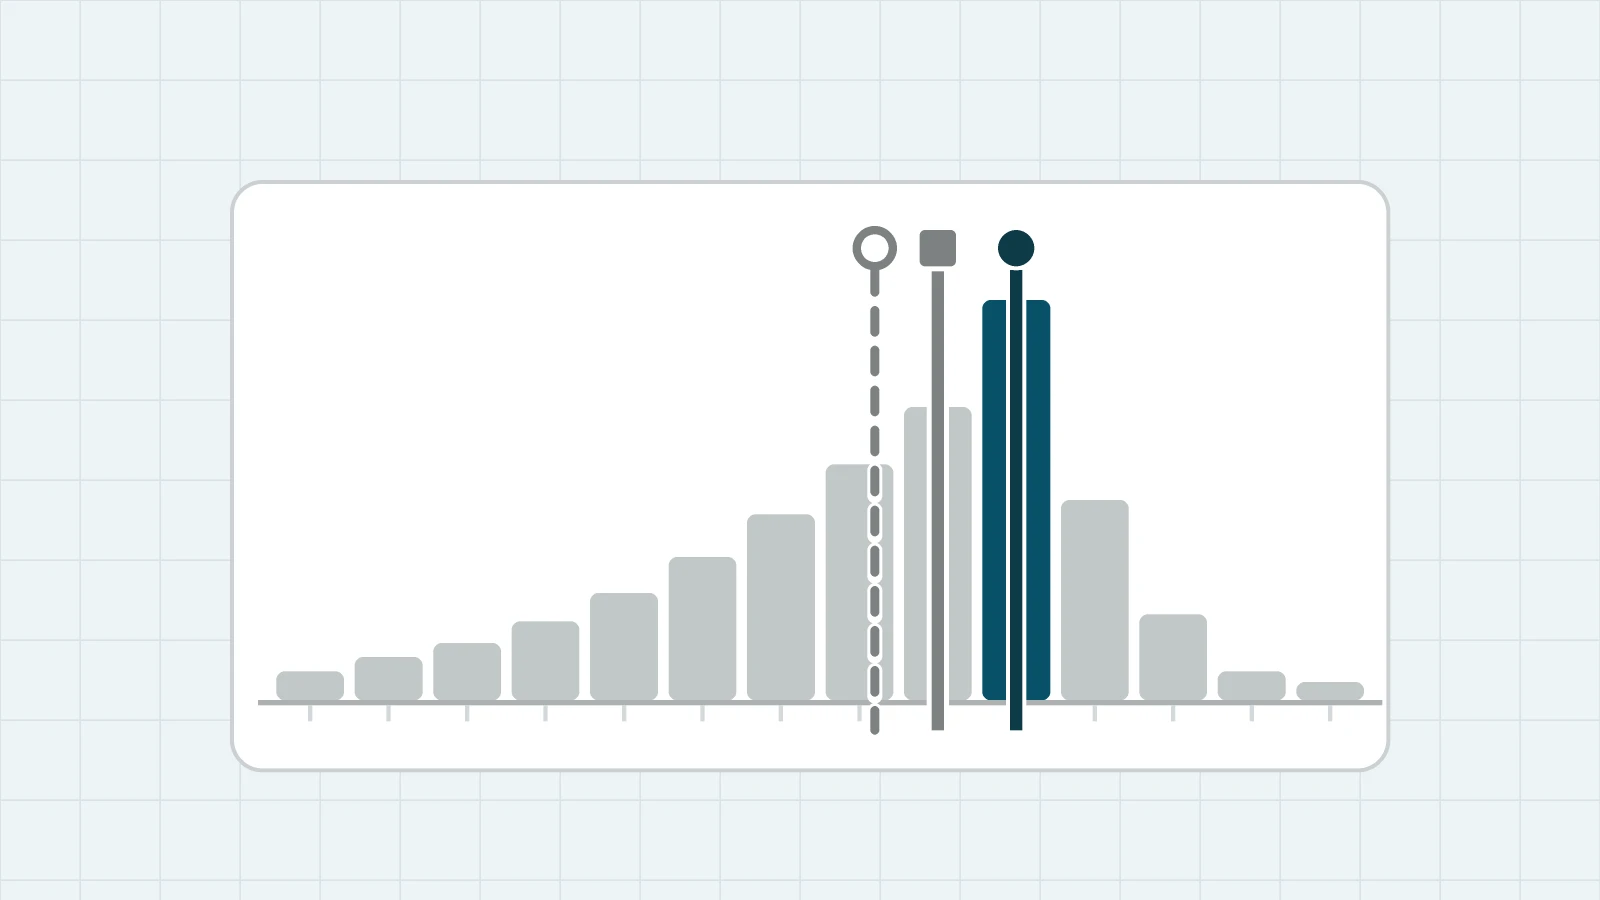
Centrummaten vatten een hele reeks antwoorden samen in een typische, centrale waarde. In marktonderzoek gebruik je er drie: het gemiddelde (de rekenkundige doorsnee), de mediaan (de middelste waarde) en de modus (de meest voorkomende waarde). Welke centrummaat je kiest, hangt af van het meetniveau van je data en van de vorm van de verdeling: bij symmetrische, numerieke data werkt het gemiddelde prima, bij scheve data of uitschieters is de mediaan eerlijker, en bij categorieën is de modus vaak de enige die klopt.
Elke enquête levert tientallen, soms honderden kolommen met antwoorden op. Niemand leest die rij voor rij. Je wilt een paar kerngetallen die in een oogopslag vertellen wat de typische klant vindt, koopt of verwacht. Centrummaten zijn precies dat: samenvattende getallen die het midden van je data aanwijzen. Ze lijken eenvoudig, maar de verkeerde centrummaat op de verkeerde data levert cijfers op die net zo overtuigend als misleidend zijn. Dit artikel legt uit wat centrummaten zijn, hoe je het gemiddelde, de mediaan en de modus berekent, en vooral hoe je in een concreet onderzoek de juiste maat kiest. Het is kennis die je bij elk kwantitatief onderzoek nodig hebt, van een korte poll tot een grootschalig consumentenonderzoek.
Wat zijn centrummaten?
Een centrummaat is een getal dat het centrum van een verzameling waarnemingen samenvat. Statistici spreken ook wel van de centrale tendentie: de neiging van data om zich rond een bepaald punt te verzamelen. In plaats van vijfhonderd losse tevredenheidsscores rapporteer je een gemiddelde van 7,8, of een mediaan van 8, of een modus van 8. In een getal vat je de hele groep samen.
In de praktijk werk je met drie centrummaten, en elk kijkt op een andere manier naar het midden. Het gemiddelde weegt alle waarden mee en zoekt het rekenkundige evenwichtspunt. De mediaan telt niet de waarden maar hun volgorde, en pakt de waarnemer die precies in het midden staat. De modus kijkt alleen naar welke waarde het vaakst voorkomt. Omdat ze het midden anders definiëren, geven ze bij dezelfde data soms verschillende antwoorden, en dat verschil is geen fout maar informatie.
Centrummaten vormen samen met de spreidingsmaten de basis van de beschrijvende statistiek: het deel van de analyse dat je data samenvat voordat je toetsen gaat uitvoeren of verbanden gaat zoeken. Het is het fundament onder vrijwel elke andere techniek uit het overzicht van statistische technieken in marktonderzoek. Wie het midden verkeerd samenvat, bouwt de rest van de analyse op drijfzand.
| Centrummaat | Wat het is | Wanneer passend | Gevoelig voor uitschieters? |
|---|---|---|---|
| Gemiddelde | Som van alle waarden gedeeld door het aantal waarnemingen | Numerieke, redelijk symmetrische data (interval of ratio) | Ja, sterk |
| Mediaan | De middelste waarde nadat je alles op volgorde zet | Scheve data, uitschieters, of ordinale schalen | Nee, robuust |
| Modus | De waarde die het vaakst voorkomt | Categorische data, of om de populairste optie te vinden | Nee |
Het gemiddelde: de rekenkundige doorsnee
Het rekenkundig gemiddelde is de bekendste centrummaat. Je telt alle antwoorden op en deelt door het aantal respondenten. Scoren tien klanten hun tevredenheid met 6, 7, 7, 8, 8, 8, 8, 9, 9 en 10, dan is de som 80 en het gemiddelde 8,0. Het gemiddelde gebruikt elke respondent: verandert een enkele score, dan verschuift het gemiddelde mee. Dat is zowel de kracht als de zwakte van deze maat.
De kracht is dat het gemiddelde alle informatie benut en zich makkelijk laat verder rekenen, bijvoorbeeld in een significantietoets of een regressiemodel. De zwakte is precies dezelfde gevoeligheid: een paar extreme waarden trekken het gemiddelde naar zich toe. Bij inkomens, bestedingen, doorlooptijden en andere grootheden met een lange staart kan het gemiddelde daardoor hoger uitvallen dan wat de meeste mensen daadwerkelijk ervaren. Het gemiddelde hoort thuis bij numerieke data (interval- of ratiometingen) die redelijk symmetrisch verdeeld zijn. Is de verdeling scheef, dan liegt het gemiddelde niet, maar het vertelt wel een ander verhaal dan je denkt.
De mediaan: de middelste waarde
De mediaan is de waarde die precies in het midden ligt wanneer je alle antwoorden op volgorde zet. De helft van de respondenten scoort lager, de helft hoger. Bij een oneven aantal waarnemingen is de mediaan de middelste waarde. Bij een even aantal neem je het gemiddelde van de twee middelste. Zet je de scores 3, 6, 7, 8 en 9 op een rij, dan is de mediaan 7, want twee waarden liggen eronder en twee erboven.
Het grote voordeel van de mediaan is dat hij robuust is: uitschieters raken hem niet. Of de hoogste besteding nu 500 euro of 50.000 euro is, de middelste respondent blijft dezelfde. Daarom rapporteren statistische bureaus inkomens, huizenprijzen en wachttijden bijna altijd als mediaan. De mediaan werkt ook bij ordinale data, waar categorieën wel een volgorde hebben maar geen gelijke afstanden, zoals een rangorde van voorkeuren of een Likert-schaal. Over het rekenkundig gemiddelde van zulke data valt te twisten, over de mediaan niet. De prijs die je betaalt is dat de mediaan minder informatie gebruikt: hij kijkt alleen naar de positie in de rij, niet naar hoe ver de waarden uiteen liggen.
De modus: de meest voorkomende waarde
De modus is de waarde of categorie die het vaakst voorkomt. Kiezen van honderd respondenten er veertig voor merk A, dertig voor merk B en dertig voor merk C, dan is merk A de modus. De modus is de enige centrummaat die werkt bij nominale data: categorieën zonder volgorde, zoals merkvoorkeur, regio of favoriet kanaal. Een gemiddelde of mediaan van merknamen heeft geen betekenis, maar de meest gekozen optie wel.
Bij numerieke data die je in klassen groepeert spreek je van de modale klasse: de klasse met de meeste waarnemingen. De modus heeft ook eigenaardigheden. Een verdeling kan twee toppen hebben (bimodaal), wat vaak wijst op twee verschillende groepen in je data die je beter apart bekijkt met een clusteranalyse. En soms is er helemaal geen duidelijke modus omdat alle waarden ongeveer even vaak voorkomen. In dat geval zegt het ontbreken van een piek net zoveel als een piek zelf: je markt heeft geen uitgesproken favoriet. De modus is dus minder een rekenkundig eindpunt en meer een vingerwijzing naar wat populair is. Voor het analyseren van merkkeuze of categorische antwoorden is hij onmisbaar, en hij hangt nauw samen met technieken voor categorische samenhang zoals de chi-kwadraattoets.
Gemiddelde, mediaan of modus: welke centrummaat kies je?
De keuze tussen de drie centrummaten draait om twee vragen. De eerste is het meetniveau van je variabele: wat voor soort getal of categorie heb je gemeten? Nominale data laten alleen de modus toe. Ordinale data laten de modus en de mediaan toe. Interval- en ratiodata laten alle drie toe. Het meetniveau is dus een harde grens, geen smaakkwestie. Wie een gemiddelde berekent over categorieën die eigenlijk alleen een volgorde hebben, produceert een getal zonder betekenis.
De tweede vraag speelt wanneer alle drie de maten mogen: wat is de vorm van de verdeling? Bij een symmetrische verdeling, waarvan de klokvorm van de normaalverdeling het schoolvoorbeeld is, liggen gemiddelde, mediaan en modus dicht bij elkaar en maakt de keuze weinig uit. Bij een scheve verdeling lopen ze uiteen, en dan is de mediaan meestal eerlijker. Een klein rekenvoorbeeld maakt dat concreet. Stel dat negen klanten hun ervaring scoren op een schaal van 1 tot 10:
| Scores van negen klanten | Gemiddelde | Mediaan | Modus |
|---|---|---|---|
| 1, 7, 7, 8, 8, 8, 9, 9, 10 | 7,4 | 8 | 8 |
Acht van de negen klanten zijn duidelijk tevreden (scores 7 tot 10). Een enkele ontevreden klant geeft een 1. Het gemiddelde zakt daardoor naar 7,4, terwijl de mediaan en de modus op 8 blijven staan. Wie alleen het gemiddelde rapporteert, suggereert dat de hele groep rond de 7 hangt. Wie de mediaan erbij zet, laat zien dat de typische klant een 8 geeft en dat een uitschieter het gemiddelde omlaag trekt. Allebei de cijfers kloppen, maar ze vertellen een ander verhaal. In een klanttevredenheidsonderzoek is dat onderscheid het verschil tussen een alarmsignaal en een geruststelling.
De vuistregel: bij symmetrische numerieke data pak je het gemiddelde, bij scheve data of uitschieters de mediaan, en bij categorieën de modus. Het meetniveau bepaalt wat mag, de verdeling bepaalt wat verstandig is. Welk meetniveau je data heeft, hangt samen met hoe je je vragen hebt gesteld, en dat bepaal je idealiter al bij het ontwerp van de vragenlijst, lang voor de analyse.
| Meetniveau | Voorbeeld in marktonderzoek | Toegestane centrummaat | Beste keuze meestal |
|---|---|---|---|
| Nominaal | Merkvoorkeur, regio, kanaal | Modus | Modus |
| Ordinaal | Rangorde, opleidingsniveau, voorkeursvolgorde | Modus, mediaan | Mediaan |
| Interval / ratio | Leeftijd, besteding, aantal aankopen, tevredenheidsscore | Modus, mediaan, gemiddelde | Gemiddelde of mediaan, afhankelijk van de vorm |
Centrummaten en spreidingsmaten horen samen
Een centrummaat op zichzelf is een halve waarheid. Hij vertelt waar het midden ligt, maar niet hoe ver de antwoorden uiteen liggen. Twee productvarianten kunnen allebei een gemiddelde tevredenheid van 7,5 scoren, terwijl de een vrijwel iedereen tussen 7 en 8 heeft en de ander een mix is van enthousiaste 9’s en teleurgestelde 5’s. Het gemiddelde is gelijk, de realiteit totaal verschillend. Daarom rapporteer je een centrummaat nooit zonder een spreidingsmaat ernaast.
Bij elke centrummaat hoort een natuurlijke partner. Bij het gemiddelde past de standaarddeviatie, ook wel de standaardafwijking genoemd: de gemiddelde afstand van de waarnemingen tot het gemiddelde. Bij de mediaan past de interkwartielafstand: het bereik waarin de middelste helft van de respondenten valt. Bij de modus kijk je naar hoe dominant die ene categorie is ten opzichte van de rest. De spreiding vertelt je of je centrummaat de groep goed vertegenwoordigt of alleen een gammele doorsnee van sterk verdeelde meningen is. Een goede datavisualisatie, zoals een histogram of een boxplot, laat het midden en de spreiding in een oogopslag samen zien.
| Centrummaat | Bijbehorende spreidingsmaat | Wat de spreiding vertelt |
|---|---|---|
| Gemiddelde | Standaarddeviatie (en variantie) | Hoe ver antwoorden gemiddeld van het gemiddelde af liggen |
| Mediaan | Interkwartielafstand en spreidingsbreedte | Het bereik van de middelste 50 procent van de respondenten |
| Modus | Aandeel van de modale categorie | Hoe sterk de populairste optie eruit springt |
De betrouwbaarheid van elke centrummaat hangt bovendien af van je steekproef. Een gemiddelde uit dertig respondenten wiebelt meer dan hetzelfde gemiddelde uit driehonderd, en een scheve of te kleine steekproef maakt elk kerngetal kwetsbaar. Bepaal daarom de steekproefgrootte vooraf en zorg voor een representatieve groep, eventueel gecorrigeerd met weging. Pas dan zegt je centrummaat iets over de markt en niet alleen over de toevallige mensen die meededen.
Vijf valkuilen bij centrummaten in marktonderzoek
Centrummaten berekenen is tegenwoordig een kwestie van een knop indrukken. Elk enquêtepakket, elk dashboard en elke AI-assistent spuwt binnen een seconde een gemiddelde uit, van welke kolom dan ook, of dat gemiddelde nu betekenis heeft of niet. Juist omdat de rekenstap gratis is geworden, is de drempel om een fout cijfer te produceren gedaald. De software controleert niet of het meetniveau een gemiddelde toelaat, of de verdeling scheef is, of er uitschieters zijn. Dat oordeel blijft mensenwerk, en daar ligt de toegevoegde waarde van een onderzoeker. Dit zijn de vijf valkuilen die wij in de praktijk het vaakst zien.
Stuk voor stuk zijn dit beslissingen die geen enkel algoritme voor je neemt. Ze vragen kennis van je data, van je doelgroep en van de vraag achter het onderzoek. Dat is precies waarom goede centrummaten geen reken-, maar een interpretatiekwestie zijn.
Van kerngetal naar beslissing
Centrummaten zijn de eerste stap van elke kwantitatieve analyse, maar nooit de laatste. Ze vertellen waar het midden van je markt ligt; de spreiding vertelt hoe betrouwbaar dat midden is, en toetsen en modellen vertellen of verschillen tussen groepen echt zijn of toeval. Een gemiddelde dat tussen twee productgroepen verschilt, hoeft nog geen echt verschil te zijn, en een samenhang tussen twee kerngetallen is nog geen oorzaak: wie dat onderscheid kent, verwart correlatie niet met causaliteit. Wie die stappen overslaat en alleen een rij gemiddelden presenteert, levert cijfers zonder verhaal. Het bredere kader daarvoor vind je in onze gids over marktonderzoek. Wil je de kerngetallen uit je onderzoek vertalen naar onderbouwde keuzes, bekijk dan wat de verschillende soorten marktonderzoek van BABLR voor je kunnen betekenen, of lees hoe een marktonderzoek bij ons verloopt. Zo zorgen we samen dat elk getal in je rapport klopt en iets betekent.
Veelgestelde vragen over centrummaten
Centrummaten, ook de centrale tendentie genoemd, vatten een hele reeks antwoorden samen in een typische of centrale waarde. In marktonderzoek gebruik je er drie: het gemiddelde (de rekenkundige doorsnee), de mediaan (de middelste waarde na sortering) en de modus (de meest voorkomende waarde).
Het gemiddelde telt alle waarden op en deelt door het aantal, en gebruikt dus elke respondent. De mediaan is de middelste waarde en trekt zich niets aan van hoe extreem de uitersten zijn. De modus is simpelweg de waarde die het vaakst voorkomt. Daardoor reageren ze verschillend op uitschieters en op de vorm van de verdeling.
Gebruik de mediaan wanneer je verdeling scheef is of enkele uitschieters bevat, bijvoorbeeld bij inkomen, bestedingen of doorlooptijden. Een paar extreme waarden trekken het gemiddelde mee, terwijl de mediaan de typische respondent blijft weergeven. Ook bij ordinale data (zoals rangordes) is de mediaan vaak passender dan het gemiddelde.
Bij nominale data (categorieën zonder volgorde) kan alleen de modus. Bij ordinale data (een volgorde zonder gelijke afstanden) mag de modus en de mediaan. Bij interval- en ratiodata (echte getallen) mogen alle drie, en kies je op basis van de vorm van de verdeling.
Een centrummaat vertelt waar het midden ligt, maar niet hoe ver de antwoorden uit elkaar liggen. Twee groepen met hetzelfde gemiddelde kunnen totaal verschillen: de een eensgezind, de ander sterk verdeeld. Daarom rapporteer je een centrummaat altijd samen met een spreidingsmaat zoals de spreidingsbreedte, de interkwartielafstand of de standaarddeviatie.
Dat hangt af van de spreiding in je data en van de precisie die je wilt. Hoe groter de spreiding, hoe meer respondenten je nodig hebt om het gemiddelde met een smalle foutmarge te schatten. Een gemiddelde uit een kleine of scheve steekproef is kwetsbaar, dus bepaal de steekproefgrootte vooraf en kijk altijd naar de spreiding naast het gemiddelde.