De Spearman-correlatie, ook rangcorrelatie of Spearmans rho genoemd, meet hoe sterk en in welke richting twee variabelen samen bewegen op basis van hun rangorde in plaats van hun exacte waarden. Ze drukt die samenhang uit in een getal tussen min 1 en plus 1 en is de aangewezen maat wanneer je werkt met ordinale data, een niet-normale verdeling of een verband dat wel stijgt of daalt maar niet volgens een rechte lijn. Waar de Pearson-correlatie een lineair verband veronderstelt, vraagt de Spearman-correlatie alleen dat hogere scores op de ene variabele samengaan met consistent hogere, of consistent lagere, scores op de andere.
In marktonderzoek werk je zelden met perfect verdeelde cijfers. Tevredenheid wordt gemeten op een schaal van 1 tot 10, voorkeuren worden gerangschikt, en een enkele uitschieter kan je gemiddelde flink optillen. Precies in die situaties biedt de Spearman-correlatie een robuust alternatief voor de klassieke Pearson-correlatie. In deze gids lees je wat rangcorrelatie precies is, waarin ze verschilt van Pearson, wanneer je ze inzet, hoe je ze berekent en hoe je de uitkomst leest. We plaatsen de techniek in het bredere kader van de meest gebruikte statistische technieken in marktonderzoek.
Spearman-correlatie: samenhang gemeten op rangen
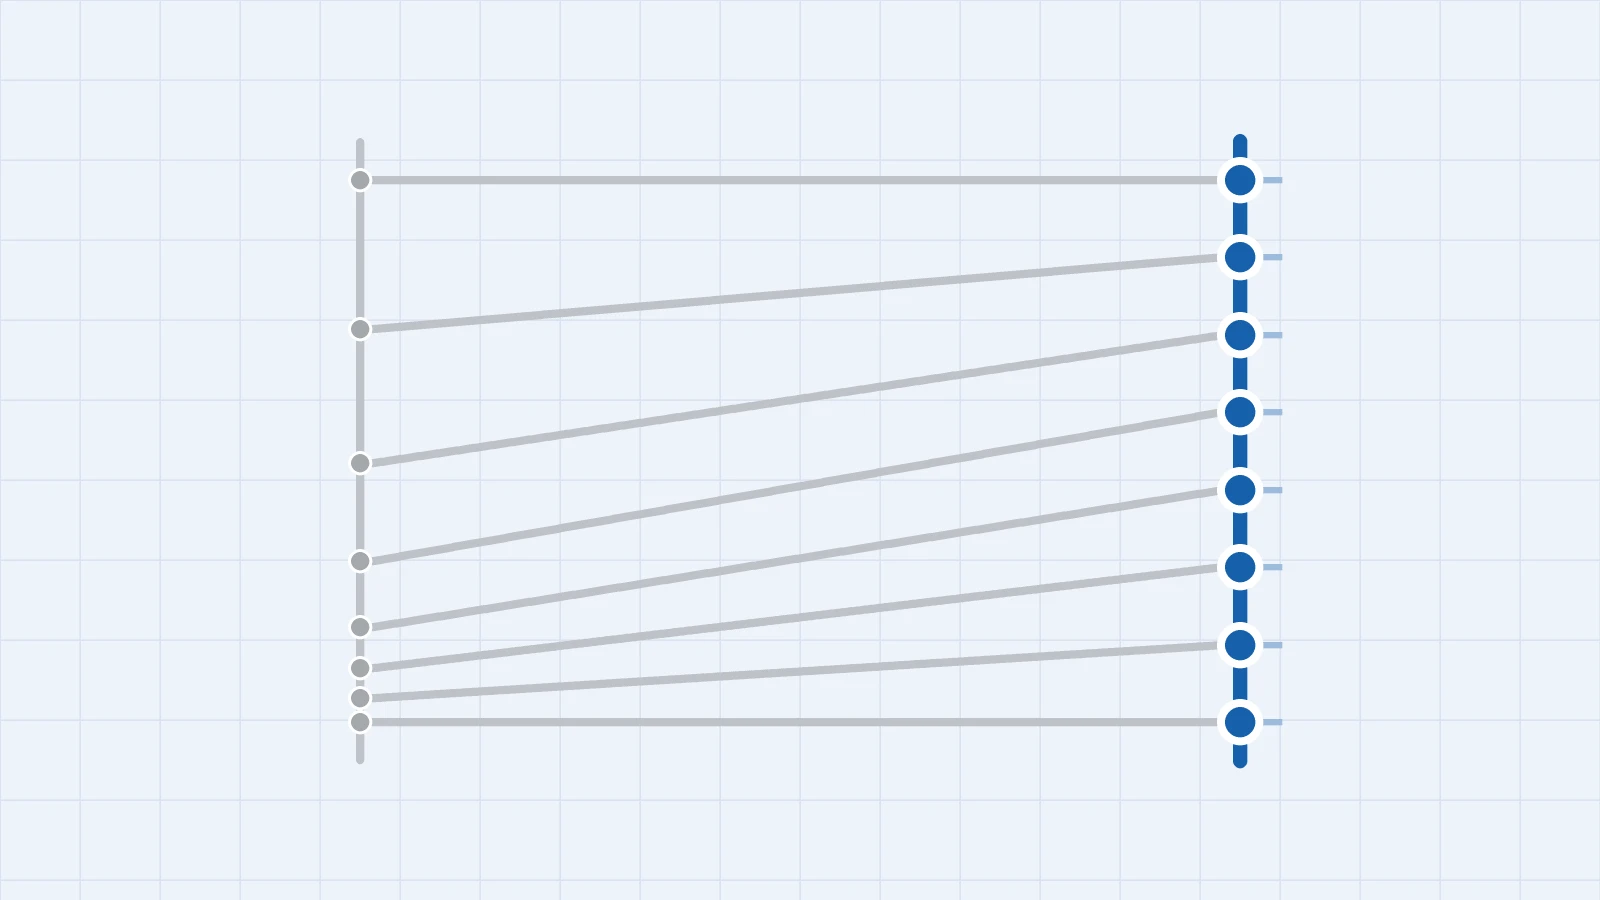
De rangcorrelatiecoëfficiënt werd in 1904 beschreven door de Britse psycholoog Charles Spearman. Hij zocht een manier om samenhang te meten zonder aannames over de precieze vorm van de data, en het antwoord lag in de rangen. In plaats van de ruwe waarden te vergelijken, zet je elke variabele om in een rangorde van laag naar hoog en bereken je de correlatie op die rangnummers. De uitkomst heet rho en wordt in formules geschreven als de Griekse letter ρ.
Rho beweegt tussen min 1 en plus 1. Een waarde van plus 1 betekent een perfect stijgend verband: de respondent met de hoogste score op variabele A heeft ook de hoogste score op variabele B, en zo verder voor elke positie. Een waarde van min 1 betekent een perfect dalend verband, en een waarde rond 0 betekent dat er geen consistente op- of neergaande lijn in de rangen zit.
Het sleutelbegrip is monotoon. Een verband is monotoon wanneer het steeds dezelfde kant op wijst: als variabele A toeneemt, gaat variabele B ofwel altijd mee omhoog, ofwel altijd omlaag, zonder van richting te wisselen. Dat is een ruimere eis dan lineair. Elk lineair verband is monotoon, maar niet elk monotoon verband is lineair: een lijn die eerst steil stijgt en daarna afvlakt, blijft monotoon zolang ze nergens daalt. Precies die ruimte maakt Spearman veelzijdiger dan Pearson. Omdat de maat alleen met rangen werkt, is ze bovendien robuust: een extreme uitschieter krijgt gewoon de hoogste of laagste rang en kan het resultaat niet langer scheeftrekken. Net als bij elke correlatie geldt wel dat samenhang geen oorzaak aantoont, een onderscheid dat we uitwerken in onze gids over correlatie en causaliteit.
Spearman tegenover Pearson: het verschil
De bekendste correlatiemaat is de Pearson-correlatie. Ze is krachtig, maar ze stelt voorwaarden: ze meet uitsluitend een lineair verband, ze veronderstelt variabelen op interval- of rationiveau en voor de toetsing gaat ze uit van ongeveer normaal verdeelde data. Bovendien is ze gevoelig voor uitschieters, omdat een enkele extreme waarde de rekensom sterk kan beïnvloeden. De Spearman-correlatie laat die voorwaarden los door met rangen te werken. Je kunt haar zien als de Pearson-correlatie die is losgelaten op de rangnummers in plaats van op de ruwe scores.
De onderstaande tabel zet de belangrijkste samenhangsmaten naast elkaar.
| Maat | Meet welk verband | Datatype | Gevoelig voor uitschieters | Typisch gebruik |
|---|---|---|---|---|
| Pearson r | Lineair, dus een rechte lijn | Interval of ratio | Ja | Twee numerieke, normaal verdeelde variabelen |
| Spearman rho | Monotoon, dus stijgend of dalend | Ordinaal of hoger | Nee | Likert-scores, rangordes, scheve data |
| Kendalls tau | Monotoon, via concordante paren | Ordinaal of hoger | Nee | Kleine steekproeven, veel gelijke rangen |
| Chi-kwadraat | Samenhang tussen categorieën | Nominaal, dus categorisch | Niet van toepassing | Kruistabellen van twee categorische vragen |
Kendalls tau is een tweede rangcorrelatie die dezelfde logica volgt als Spearman maar anders rekent; ze is handig bij heel kleine steekproeven of veel gelijke rangen. Werk je met twee zuiver categorische variabelen, dan is geen van beide rangmaten geschikt en gebruik je de chi-kwadraattoets.
Een voorbeeld maakt het verschil tussen Pearson en Spearman tastbaar. Stel dat tevredenheid snel toeneemt bij de eerste verbeteringen in je dienstverlening en daarna afvlakt: de grafiek is een stijgende maar gebogen lijn. Pearson zoekt de best passende rechte lijn en rapporteert in zo’n geval misschien een r van 0,75, omdat de kromming niet in een rechte past. Spearman kijkt enkel of de rangorde klopt, ziet dat elke stap vooruit in dienstverlening samengaat met een hogere tevredenheid, en komt uit op een rho van bijna 1. Beide cijfers zijn correct berekend, maar ze beantwoorden een andere vraag. Wie het verband wil samenvatten als zuivere sterkte van de monotone samenhang, kiest hier Spearman.
Wanneer de Spearman-correlatie de juiste keuze is
De Spearman-correlatie komt vooral van pas in vier situaties die in marktonderzoek voortdurend opduiken. Ze hebben allemaal hetzelfde kenmerk: de volgorde van de antwoorden is betekenisvol, de exacte afstanden ertussen zijn dat niet.
Concreet zet je de rangbenadering bijvoorbeeld in om de samenhang te onderzoeken tussen tevredenheid en loyaliteit in een klanttevredenheidsonderzoek, tussen de rangorde van prijsperceptie en aankoopintentie bij consumentenonderzoek, of tussen relatiesterkte en herhaalaankoop in b2b-marktonderzoek. Omdat de antwoorden op een Likert-schaal strikt genomen ordinaal zijn, is rho daar vaak de eerlijkere maat dan r. Ook bij het valideren van vragenlijsten komt rangcorrelatie van pas: scoren respondenten op twee items die hetzelfde begrip zouden meten consistent in dezelfde volgorde, dan wijst een hoge rho erop dat die items samen één dimensie vormen, de vraag die ook aan een factoranalyse ten grondslag ligt. En wanneer je twee beoordelaars onafhankelijk producten laat rangschikken, toont Spearman hoe sterk hun oordelen overeenstemmen.
Het patroon achter al deze toepassingen is steeds hetzelfde: je hebt geen keiharde meetschaal met gelijke afstanden, maar wel een betekenisvolle volgorde. Zodra dat het geval is, is de rangbenadering niet alleen toegestaan maar vaak ook eerlijker, omdat ze geen precisie voorwendt die de data niet bezitten. Dat sluit aan bij een bredere stelregel in marktonderzoek: kies de analyse die past bij het meetniveau van je data, niet omgekeerd.
De Spearman-correlatie berekenen, stap voor stap
Zolang er geen gelijke waarden in je data zitten, volgt de berekening een vaste formule:
ρ = 1 − (6 × Σd²) / (n × (n² − 1))
- d is per respondent het verschil tussen zijn rang op de ene en zijn rang op de andere variabele.
- Σd² is de som van al die rangverschillen, elk eerst gekwadrateerd.
- n is het aantal respondenten, en dus het aantal rangenparen.
Je komt daar in vier stappen.
Zitten er wel gelijke waarden in je data, dan geef je die de gemiddelde rang: twee klanten die allebei een 7 geven en samen positie 4 en 5 bezetten, krijgen beide rang 4,5. De verkorte formule hierboven geldt dan niet meer en je berekent in plaats daarvan de Pearson-correlatie op de rangnummers. Statistische software doet dat automatisch, maar reken het met de hand na zodra veel respondenten dezelfde score geven, want dan wijken de twee uitkomsten merkbaar van elkaar af.
Rekenvoorbeeld: tevredenheid en aankoopfrequentie
Stel, je onderzoekt bij acht klanten of een hogere tevredenheidsscore samengaat met meer aankopen per jaar. De ruwe scores, de toegekende rangen en de rangverschillen zien er zo uit.
| Klant | Tevredenheid (0 tot 10) | Aankopen per jaar | Rang tevredenheid | Rang aankopen | d | d² |
|---|---|---|---|---|---|---|
| A | 6 | 40 | 4 | 4 | 0 | 0 |
| B | 7 | 55 | 5 | 5 | 0 | 0 |
| C | 5 | 30 | 3 | 2 | 1 | 1 |
| D | 9 | 80 | 7 | 7 | 0 | 0 |
| E | 8 | 65 | 6 | 6 | 0 | 0 |
| F | 4 | 20 | 2 | 1 | 1 | 1 |
| G | 3 | 35 | 1 | 3 | 2 | 4 |
| H | 10 | 90 | 8 | 8 | 0 | 0 |
De som van de gekwadrateerde verschillen is 0 plus 0 plus 1 plus 0 plus 0 plus 1 plus 4 plus 0, dus Σd² komt uit op 6. Met acht klanten wordt de noemer 8 × (64 − 1), dus 504. Ingevuld geeft dat:
ρ = 1 − (6 × 6) / 504 = 1 − 0,071 = 0,93
Er is dus een zeer sterke positieve monotone samenhang: klanten met een hogere tevredenheid kopen in deze steekproef vrijwel systematisch vaker. Maar lees zo’n uitkomst nooit zonder het patroon er zelf bij te zien. Teken dit soort relaties altijd eerst uit in een spreidingsdiagram, een reflex die we toelichten in onze gids over datavisualisatie.
De waarde van rho interpreteren
Twee eigenschappen van de uitkomst lees je meteen af. Het teken geeft de richting van het verband, en de absolute grootte geeft de sterkte. Voor die sterkte hanteren onderzoekers een vuistregel.
| Waarde van rho (absoluut) | Interpretatie |
|---|---|
| 0,00 tot 0,19 | Zeer zwak verband |
| 0,20 tot 0,39 | Zwak verband |
| 0,40 tot 0,59 | Matig verband |
| 0,60 tot 0,79 | Sterk verband |
| 0,80 tot 1,00 | Zeer sterk verband |
Deze grenzen zijn richtlijnen, geen harde wetten. Of een rho van 0,45 opmerkelijk is, hangt af van je vakgebied en van je onderzoeksvraag. Rho is daarbij niet alleen een toets maar ook een maat voor de omvang van het verband, net zoals de correlatiecoëfficiënt r dat is bij Pearson; zie wat dat betekent bij effectgrootte. Even belangrijk als de grootte is de vraag of de waarde statistisch significant afwijkt van 0. Een hoge rho bij een handvol respondenten kan puur toeval zijn, terwijl een bescheiden rho in een grote steekproef wel betekenis heeft. Beoordeel de uitkomst daarom samen met de bijhorende p-waarde, een onderwerp dat we uitdiepen bij statistische significantie, en let goed op je steekproefgrootte.
De keuze van de juiste maat begint bij het datatype van je twee variabelen. De volgende tabel helpt je beslissen.
| Situatie | Aanbevolen maat |
|---|---|
| Beide variabelen numeriek, verband lineair, data ongeveer normaal | Pearson r |
| Minstens één variabele ordinaal, of verband monotoon maar niet lineair, of uitschieters aanwezig | Spearman rho |
| Kleine steekproef of veel gelijke rangen | Kendalls tau |
| Beide variabelen categorisch, dus nominaal | Chi-kwadraat met Cramérs V |
Rho toetsen: is de samenhang betrouwbaar?
Een berekende rho beschrijft uitsluitend de respondenten in je steekproef. De vraag die telt is of diezelfde samenhang ook opgaat voor de bredere doelgroep. Daarvoor toets je of rho significant afwijkt van 0. Bij kleine aantallen respondenten gebruik je een tabel met kritieke waarden voor Spearman: je rho moet een drempel overschrijden die afhangt van n en van het gekozen betrouwbaarheidsniveau. Bij grotere steekproeven, vanaf ongeveer dertig paren, benader je de toetsing met een t-verdeling en lees je rechtstreeks een p-waarde af.
De praktische les is dat grootte en significantie samen moeten worden gelezen. Een rho van 0,80 bij zes respondenten klinkt indrukwekkend, maar blijft onder de kritieke waarde van ongeveer 0,89 die je bij zes rangenparen nodig hebt: met zo weinig data is die uitkomst niet van toeval te onderscheiden. Een rho van 0,30 bij vijfhonderd respondenten is veel kleiner, maar ligt mijlenver boven zijn drempel en is dus een geloofwaardig verband. Rapporteer daarom altijd de coëfficiënt, de steekproefgrootte en de p-waarde samen, zodat de lezer de waarde op waarde kan schatten. Statistische significantie is niet hetzelfde als praktische relevantie, een nuance die elk degelijk onderzoeksrapport expliciet maakt.
Veelgemaakte fouten bij rangcorrelatie
Statistiekpakketten en AI-tools rekenen een rangcorrelatie in een fractie van een seconde uit, ook wanneer de techniek helemaal niet past bij de data. Precies daardoor daalt de drempel om een fout verband te rapporteren: de knop is makkelijk, de interpretatie niet. Een ervaren onderzoeker weet niet alleen welke waarde eruit komt, maar ook of ze mag worden berekend en wat ze wel en niet betekent. Vijf valkuilen keren steeds terug.
Een scheve of niet-representatieve steekproef vertekent bovendien elke correlatie, hoe netjes de formule ook wordt ingevuld. Het bredere verschil tussen cijfermatig meten en betekenisvol duiden loopt als een rode draad door het onderscheid tussen kwalitatief en kwantitatief onderzoek. Een correlatiecoëfficiënt is een begin van het verhaal, geen eindpunt.
Van rangcorrelatie naar bruikbaar inzicht
De Spearman-correlatie is een eenvoudige maar veelzijdige maat die zich thuis voelt in de ruige werkelijkheid van enquêtedata: ordinale schalen, scheve verdelingen en uitschieters. Ze vertelt je of twee kenmerken samen oplopen, maar de echte waarde ontstaat pas wanneer die uitkomst correct wordt gekozen, getoetst en vertaald naar een beslissing. Benieuwd welke analyses jouw vraagstuk vooruithelpen? Ontdek onze soorten marktonderzoek of lees hoe een marktonderzoek via BABLR verloopt. Zo weet je zeker dat je cijfers de juiste richting op wijzen.
Veelgestelde vragen over de Spearman-correlatie
De Spearman-correlatie, ook rangcorrelatie of Spearmans rho genoemd, meet hoe sterk en in welke richting twee variabelen samen bewegen op basis van hun rangorde in plaats van hun exacte waarden. De uitkomst ligt tussen min 1 en plus 1. Een waarde rond plus 1 betekent dat hogere scores op de ene variabele samengaan met hogere scores op de andere, een waarde rond min 1 betekent het tegenovergestelde en een waarde rond 0 betekent geen monotone samenhang.
De Pearson-correlatie meet een lineair verband tussen twee variabelen op interval- of rationiveau, en voor de toetsing gaat ze uit van ongeveer normaal verdeelde data. De Spearman-correlatie werkt op rangen, meet elk stijgend of dalend verband en is geschikt voor ordinale data, scheve verdelingen en datasets met uitschieters. Spearman is in feite de Pearson-correlatie toegepast op de rangnummers.
Gebruik Spearman wanneer minstens een van je variabelen ordinaal is, bijvoorbeeld een Likert-schaal of een rangordevraag, wanneer de data niet normaal verdeeld zijn, wanneer er duidelijke uitschieters zijn, of wanneer het verband wel consistent stijgt of daalt maar geen rechte lijn volgt. In die situaties geeft Pearson een vertekend beeld en Spearman niet.
Rangschik eerst beide variabelen apart van laag naar hoog. Bereken per respondent het verschil tussen de twee rangen, kwadrateer dat verschil en tel alle gekwadrateerde verschillen op. Rho is dan gelijk aan 1 min 6 maal die som, gedeeld door n maal n kwadraat min 1, waarbij n het aantal respondenten is. Bij gelijke rangen geef je de gemiddelde rang en bereken je de Pearson-correlatie op de rangnummers.
Het teken geeft de richting: plus is een positief verband, min een negatief. De grootte geeft de sterkte. Als vuistregel geldt: tot 0,19 zeer zwak, 0,20 tot 0,39 zwak, 0,40 tot 0,59 matig, 0,60 tot 0,79 sterk en 0,80 tot 1,00 zeer sterk. Die grenzen zijn richtlijnen en geen harde wetten: of een waarde betekenisvol is hangt ook af van de context en van de statistische significantie bij jouw steekproefgrootte.
Technisch kun je rho al bij een handvol paren berekenen, maar de drempel voor significantie ligt dan hoog: bij zes paren moet rho boven ongeveer 0,89 liggen voor je van een betekenisvol verband mag spreken. Voor een betrouwbare uitspraak werk je daarom met minstens enkele tientallen respondenten, en bij voorkeur een honderdtal of meer. Hoe kleiner de steekproef, hoe groter de kans dat een hoge rho niet statistisch significant is.